Cette situation vous est sans doute familière : l’information existe quelque part, vous en êtes convaincu. Dans un contrat, une politique interne, un rapport de recherche. Peut-être dans une présentation partagée il y a six mois. Le vrai défi n’est pas de produire davantage d’information — c’est de trouver la bonne, de la comprendre rapidement et de la mettre à profit au moment où vous en avez besoin.
Imaginez maintenant cette réalité à l’échelle d’une organisation tout entière.
Les entreprises accumulent depuis des années un savoir précieux dans des contrats, des politiques internes, des rapports, des travaux de recherche, des guides opérationnels et d’autres documents métier. Ces documents reflètent la façon dont une organisation pense, fonctionne et prend ses décisions. Pourtant, une grande partie de cette intelligence reste difficile à exploiter. Selon IDC, seulement la moitié du contenu non structuré d’une organisation est analysée pour en extraire de la valeur.
Cet impact se manifeste de deux façons. Dans le travail quotidien, selon une étude Adobe, les collaborateurs et collaboratrices consacrent plus de trois jours par semaine à lire, résumer et recréer des documents qui contiennent déjà l’information dont ils ont besoin. Dans les processus métier à plus forte valeur ajoutée, des informations critiques peuvent être dispersées à travers des centaines, voire des milliers de contrats, de factures, de rapports et d’autres fichiers que les équipes doivent examiner et comparer.
L’IA crée une opportunité réelle de changement, mais elle fait aussi monter les enjeux. Les collaborateurs et collaboratrices s’attendent de plus en plus à pouvoir poser une question et obtenir une réponse immédiate. Selon TELUS Digital, 57 % du personnel des entreprises a déjà copié-collé des informations sensibles dans des outils d’IA publics pour obtenir une réponse.
Pour les entreprises, le défi ne consiste pas simplement à donner à l’IA accès à davantage d’informations. Il s’agit de lui permettre de comprendre les documents dans lesquels ces informations résident, tout en préservant le contexte, la structure, les sources et les contrôles sur lesquels les organisations s’appuient.
Cela exige une couche documentaire.
Pourquoi les entreprises ont besoin d’une couche documentaire
Une couche documentaire donne à l’IA la capacité de comprendre et de préserver la structure, le contexte, la provenance et les sources des informations contenues dans les documents métier. Sans elle, l’IA ne voit que du texte. Avec elle, l’IA saisit le sens.
Un contrat comprend des clauses qui s’articulent les unes aux autres sur plusieurs pages. Un rapport financier relie des chiffres à un texte narratif, à des tableaux et à des notes de bas de page.
Une politique peut comporter une seule exception qui modifie entièrement le sens de la règle.
Une IA qui traite un document comme du texte brut risque de passer à côté des relations qui donnent tout son sens à l’information. Une couche documentaire permet à l’IA de raisonner sur les informations contenues dans les documents, tout en les maintenant connectées aux sources auxquelles les organisations font déjà confiance.
Redéfinition du standard de productivité documentaire de confiance
C’est le socle qu’Adobe construit depuis plus de trente ans. Acrobat est déjà au cœur de la gestion des contenus professionnels les plus critiques des organisations : contrats, déclarations financières, dossiers RH, soumissions réglementaires et autres documents où la précision est non négociable. L’opportunité est désormais d’étendre ces capacités à l’IA, sans que les entreprises aient à faire des compromis sur la sécurité, la gouvernance ou la vérification.
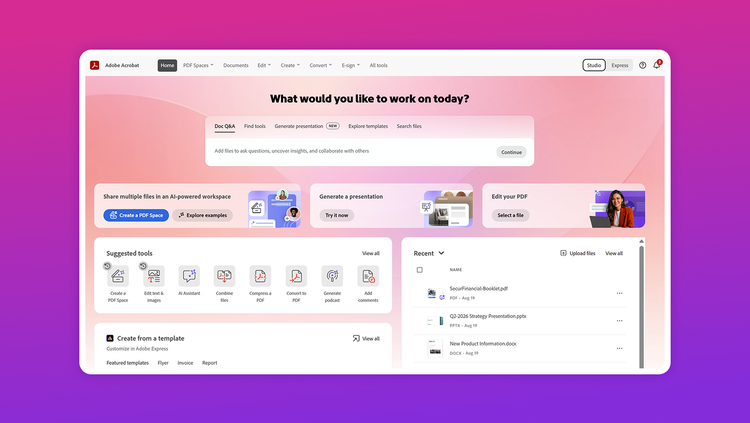
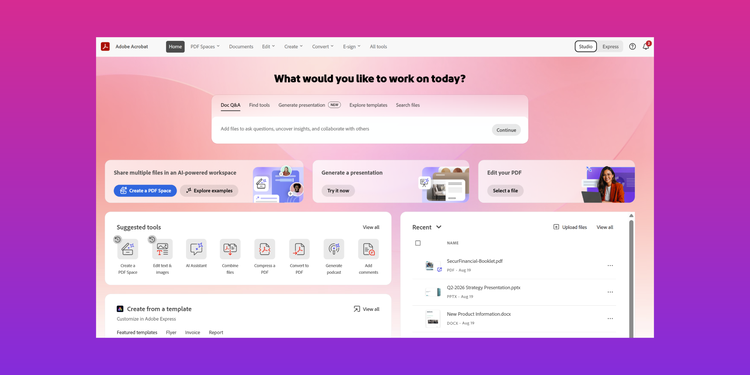
Cette évolution est déjà tangible dans la façon dont les équipes utilisent Acrobat aujourd’hui. En s’appuyant sur une IA ancrée dans des fichiers de confiance, les équipes peuvent comprendre et exploiter les documents plus rapidement, de la révision, de la comparaison et de la synthèse d’informations à la création de livrables professionnels soignés et conformes à la marque avec Adobe Express.
Acrobat enrichit également la façon dont les utilisateurs et utilisatrices interagissent avec les informations contenues dans les documents. De nouvelles fonctionnalités permettent de transformer des fichiers denses en rapports visuels interactifs et en diaporamas de synthèse, ou de faciliter l’assimilation de l’information grâce à des podcasts personnalisés, des résumés audio et des expériences de lecture à voix haute.
En savoir plus ici.
Ces expériences rendent l’IA plus utile dans le cadre du travail documentaire quotidien. Mais l’opportunité va bien au-delà d’aider une personne à la fois à comprendre ou à exploiter un document. Il s’agit de permettre aux organisations de valoriser, à grande échelle, les connaissances réparties dans l’ensemble de leurs collections documentaires.
C’est la prochaine étape de l’évolution d’Acrobat : passer du standard pour les documents de confiance à la couche d’intelligence construite sur leur base.
Intelligence à grande échelle avec Knowledge Base et Analyzer
La grande opportunité ne se résume plus à un document à la fois.
C’est ce qui devient possible lorsque les organisations peuvent analyser l’ensemble des collections documentaires qui font tourner leur activité, en transformant ces informations en connaissances exploitables par leurs équipes et en données structurées sur lesquelles s’appuyer pour agir.
Désormais disponible dans Acrobat, Knowledge Base transforme des collections documentaires organisées — politiques, playbooks, informations produits, recommandations tarifaires, études — en réponses sourcées, accessibles depuis Slack, Microsoft Teams, Acrobat et partout où les équipes travaillent déjà.
Au lieu de chercher les bonnes informations dans de multiples fichiers, les équipes peuvent interroger l’ensemble de ces connaissances et obtenir des réponses reliées à leur source. En interne chez Adobe, nous avons appliqué cette approche à plus de 6 000 rapports de recherche. Dès le premier mois, les équipes ont posé plus de 1 000 questions, et l’utilisation des recherches a progressé de 46 % d’une année sur l’autre. En savoir plus sur Knowledge Base.
Analyzer répond à un besoin différent : transformer les informations contenues dans de grands ensembles de documents en données structurées et vérifiables. Il peut analyser des milliers de contrats ou de factures et identifier des informations critiques — dates de renouvellement, clauses de revenus, obligations ou exceptions — sans révision manuelle ni entraînement de modèle personnalisé. Les informations autrefois enfouies dans des fichiers deviennent ainsi des données exploitables par les services financiers, les achats, la conformité et les systèmes qui les soutiennent. En savoir plus sur Analyzer.
Ces fonctionnalités réunies transforment le rôle des documents au sein de l’entreprise. Une politique devient une réponse que chaque collaborateur ou collaboratrice peut vérifier en quelques secondes. Un corpus de recherches devient une intelligence institutionnelle que les équipes peuvent mobiliser pour leurs décisions produit et client. Un portefeuille de contrats fournisseurs devient des données comparables sur lesquelles les achats peuvent s’appuyer pour négocier, plutôt qu’une pile de fichiers que personne n’a le temps d’examiner entièrement. Les organisations qui agiront en premier travailleront non seulement plus vite ; elles prendront aussi des décisions mieux éclairées grâce aux connaissances qu’elles possèdent déjà.
À mesure que l’IA prend davantage de place dans ces décisions, la confiance devient un enjeu fondamental. Les dirigeants et dirigeantes doivent savoir d’où vient une réponse, si elle peut être vérifiée et comment les informations sous-jacentes sont gouvernées. L’infrastructure de Knowledge Base et d’Analyzer repose sur les fondations d’Acrobat Sign et opère dans le cadre du Common Controls Framework (CCF) d’Adobe, qui définit des contrôles de sécurité et de conformité standardisés. Les réponses et informations extraites restent liées à leurs sources, permettant aux équipes de valider les informations avant de prendre toute décision.
Découvrez comment Adobe exploite les informations de ses propres données avec Acrobat ici.
Intelligence documentaire en action
Pour les responsables technologiques, l’impératif est clair : traiter les documents de l’organisation comme un asset stratégique. Le prochain avantage concurrentiel lié à l’IA ne découlera pas uniquement de nouveaux modèles ou d’une multiplication des copilotes. Il viendra de la connexion entre les informations auxquelles les entreprises font déjà confiance et les décisions, les workflows et les équipes qui font avancer l’activité.
Les connaissances sont déjà là. L’avantage appartiendra aux organisations capables de les mettre à profit.
En savoir plus sur Adobe Acrobat Studio.