ビジネスインテリジェンスの失敗には、共通したパターンがあります。整然として見えるダッシュボードが、実は適切に準備されていないデータを基に構築されている場合です。データ変換は、こうした失敗を防ぐプロセスです。データ変換を理解することが、真に信頼することができる分析基盤を構築するための第一歩となります。
主な内容:
データ変換とは何か?
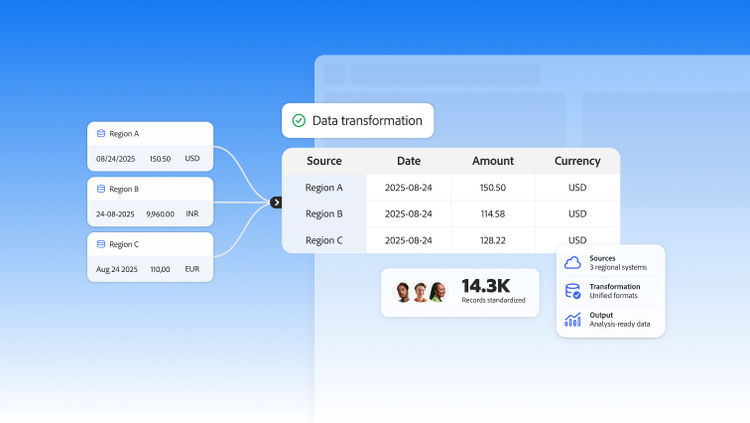
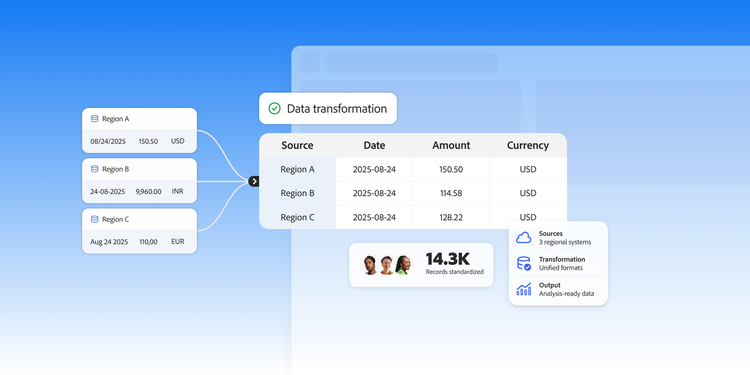
データ変換とは、生のデータを元のフォーマットや構造から、分析や後続システムでの利用に適した整合性のある形式に変換するプロセスです。例として、3つの地域データベースから売上記録を取得する小売業者を考えてみましょう。各データベースでは日付フォーマットや通貨コードが異なっています。レポートツールで地域をまたいだ比較を行うためには、標準化された日付、共通の通貨、統一されたフィールド名を持つ一つのスキーマにデータを変換する必要があります。
より広いデータパイプラインの中で、変換はデータの取り込み(データの読み込み)とロード(ウェアハウスや分析プラットフォームへの送信)の間に位置します。変換には、役割に応じてさまざまな担当者が関与します。データエンジニアがルールを定義し、ビジネスアナリストがアウトプットを検証し、マーケティングオペレーションチームはダッシュボード、セグメンテーションツール、アクティベーションプラットフォームで結果を活用します。
複数のデータソースを持つ組織にとって、変換は欠かせない要素となります。単一のCRMシステムであれば変換の必要性はほぼありませんが、そのCRMが広告プラットフォーム、サポートチケットツール、web分析システムと連携した途端、フィールド名、データ型、レコード形式のあらゆる違いが潜在的な競合を引き起こします。変換とは、こうした競合を体系的に解消するプロセスです。場当たり的な修正ではなく、データがシステム間を移動するたびに適用される、再現可能なルールベースのロジックによって解決することができます。
この点は重要です。データ変換は一度きりのデータ整理作業ではなく、継続的なパイプライン管理の規律です。ソースシステムは変化し、新しいフィールドが追加され、形式もずれていきます。変換をプロセスではなくプロジェクトとして捉える組織は、数か月以内にデータ品質が低下し始めます。
データ変換の主な種類とは
データ変換にはいくつかの明確なカテゴリがあり、それぞれが特定のデータ品質の問題に対処します。各種類を理解することで、チームは明らかな問題だけでなく、あらゆる障害モードに対応したパイプラインを設計することができます。
- 正規化は、値を標準的なスケールまたは形式に再構成します。例えば、すべての電話番号をE.164形式 (+1XXXXXXXXXX) に変換することで、CRMとメッセージングプラットフォーム間での照合が確実になります。正規化を行わないと、同じ電話番号を持つお客様が、あるシステムでは「(555) 867-5309」、別のシステムでは 「15558675309」 として保存され、異なる2人の人物として認識されてしまう可能性があります。
- 集計は、細かなレコードを要約メトリクスにまとめます。日次売上合計を必要とする財務ダッシュボードは、クエリ実行のたびに数百万件のトランザクション行を処理すべきではありません。変換処理の段階でトランザクションごとの売上を日次合計に集約することで、下流のレポーティングをより高速かつ低コストで実現することができます。
- フィルタリングは、品質や関連性の基準を満たさないレコードを除外します。解約率を算出する前に、お客様数からテストアカウントを除外することはよくある例です。変換処理の段階でテストアカウントをフィルタリングしないと、お客様数に依存するすべての下流の指標が実際より大きな値になってしまいます。
- マッピングとフィールド名の変更は、ソース間で一貫性のないフィールド名を統一します。あるシステムでは 「cust_id」 として保存されているデータが、別のシステムでは 「customer_identifier」 として保存されています。変換処理によって両方を正規の 「customer_id」 に統一することで、ウェアハウス内の結合とルックアップが正しく機能します。
- エンリッチメントは、セカンダリソースから追加の属性を付加します。サードパーティプロバイダーから企業規模や業種などの企業属性データをコンタクトレコードに追加することは、典型的なエンリッチメントの手順です。実装パターンの詳細については、データエンリッチメントに関する解説を参照してください。
- 匿名化とマスクは、個人を特定できる値をトークンや合成データに置き換えます。分析ベンダーとデータを共有する前に、メールアドレスをハッシュ化された識別子に置き換えることは標準的な手法です。実装の詳細については、データ匿名化の手法を参照してください。
- 型変換は、フィールドのデータ型を変更する処理です。文字列形式の日付(「2024-01-15」)を適切な日付型に変換することで、BIツールはカレンダー期間ごとの並び替えやフィルタリングができるようになります。型変換を行わない場合、日付の比較が失敗したり、並び順が正しく機能しなくなる可能性があります。
実際のパイプラインの多くは、複数の変換タイプを順番に適用します。マーケティングデータのパイプラインでは、ボットのトラフィックのフィルタリング、フィールド名のマッピング、日付フォーマットの正規化、日次セッション数へのデータ集計など、データがレポートレイヤーに到達する前にさまざまな処理が実行されます。
データ変換プロセスの仕組みとは?
データ変換プロセスは、決められた順序のステップで構成されています。いずれかのステップをスキップすると後続処理でエラーが発生し、破損したデータを使ったビジネス上の意思決定が行われるまで問題が見過ごされることも少なくありません。各ステップの具体的な活用例については、データ変換の事例を参照してください。
ステップ1:ソースデータのプロファイリング。変換ルールを作成する前に、アナリストは受信データにnull値、重複、型の不一致、外れ値がないか監査します。CRMエクスポートのプロファイリングを行うと、レコードの12%にメールアドレスがない、「state」フィールドに略称と正式名称が混在している、一部のレコードの作成日が1900年になっているといった問題が明らかになることがあります。プロファイリングによって問題の全容が把握でき、必要な変換タイプを特定することができます。
ステップ2:変換ルールの定義。エンジニアとアナリストが共同で、「良質な」データの基準を明確にします。ルールはドキュメント化され、パイプラインが実行されるたびに一貫して適用されるようにします。これにより、チームメンバーによる解釈のばらつきを防ぐことができます。例えば、「すべての日付フィールドはUTCのISO 8601形式(YYYY-MM-DD)に変換する。メールアドレスがnullのレコードは保持するが、data_quality_warningフィールドを'missing_email'に設定してフラグを立てる。」といったルールが定義されます。このステップでは、ルールを記述する前にターゲットスキーマを定義する必要があるため、データモデリングに関する意思決定も同時に行われます。
ステップ3:変換の適用。ルールはコード(SQL、Python)、ビジュアルETLまたはELTツール、あるいは宣言型変換フレームワークを通じて実行されます。このステップで、生データがターゲット形式に変換されます。
ステップ4:出力の検証。変換後のデータは、想定される行数、値の範囲、参照整合性チェックと照合してテストされます。行数の減少が定義されたしきい値を超えた場合は、データがウェアハウスに到達する前にアラートを発生させる必要があります。このステップでのデータ検証こそが、信頼性の高いパイプラインと、下流のレポートに気づかないうちに誤りをもたらすパイプラインの差を生み出します。
実際には、このプロセスは一直線には進みません。検証に失敗した場合は、ルールを修正するためにステップ2に戻る必要があります。データ変換を継続的なパイプライン管理ではなく、単発のプロジェクトとして捉える組織では、ソースシステムの変化や対応する変換ルールなしに新しいフィールドが追加されるにつれて、時間の経過とともにデータ品質が低下していく傾向があります。
重要なポイント:変換の品質は、実行段階ではなくルール定義の段階で決まります。ステップ2に十分な時間を投資することで、ステップ4でのエラー対応コストを削減することができます。
ETLとELTの違いとは?
ETL (Extract, Transform, Load) とELT (Extract, Load, Transform) は、パイプラインでデータ変換を実行する二大アーキテクチャパターンです。その違いは単なる処理順序にとどまらず、コスト、遅延、チームのスキルセットにまで直接影響を及ぼします。
ETLは、専用の処理レイヤーでデータがウェアハウスに到達する前に変換を実行します。このパターンは、コンプライアンス要件や個人識別情報(PII)の機密性、またはターゲットシステムのコンピューティングキャパシティが限られているなど、生データをウェアハウスに取り込んではならない環境に最適です。患者記録を共有分析環境に取り込む前に匿名化しなければならない医療機関は、ETLの典型的なユースケースです。トレードオフは遅延です。データは完全に変換されるまでクエリを実行できないため、インサイトを得るまでの時間が長くなります。
ELTは、まず生データをウェアハウスにロードし、その後SQLや宣言型変換フレームワークを使用してウェアハウス内で変換処理を実行します。このパターンは、コンピューティングが弾力的でデータと並行してバージョン管理が行える、Snowflake、BigQuery、Redshiftのようなクラウドデータウェアハウスに最適です。アナリストは同じ環境で生データと変換済みデータの両方をクエリすることができるため、デバッグや探索的分析を迅速に進めることができます。トレードオフとして、ウェアハウスが生データのストレージコストを負担する必要があり、生データの保持に関して厳格な規制要件を持つ組織は、追加のアクセス制御が必要になる場合があります。
クラウドウェアハウスの計算コストが過去10年間で大幅に低下したことから、業界はほとんどの分析ワークロードでELTへと移行しています。ただし、データを共有環境に取り込む前に匿名化するなど、変換ロジックをウェアハウス外で実行しなければならない場合は、ETLが依然として適切な選択肢です。多くの組織では、機密性の高いデータストリームにはETL、それ以外にはELTを使用するハイブリッドアプローチを採用しています。
データ変換が企業にもたらすメリットとは?
システム間でデータ品質を統一することで、アナリストが多くの時間を費やしがちなデータ照合作業を削減できます。こうした作業はアナリストの総業務時間の20〜40パーセントに相当するとも言われていますが、社内で具体的な数値を引用する前に、各組織が自社のベースラインを計測することが重要です。削減できた時間は、データの整理ではなく、分析や意思決定のサポートに充てることができます。
変換によって、さまざまな業務部門のデータを結合して分析することができます。CRM、広告プラットフォーム、web分析データ を共通のスキーマに変換済みの企業であれば、お客様ごとの顧客獲得コストを算出することができます。各システムが異なる顧客識別子や日付形式を使用している限り、この計算は不可能です。こうしたデータセットを結合できるのは、変換時に適用されるフィールドマッピング、正規化、データ標準化の直接的な成果です。
構造化された変換は、規制コンプライアンスの確保にも直接貢献します。匿名化とマスクを変換レイヤーの必須ステップとして組み込むことで、ダウンストリームのすべてのシステムが自動的にコンプライアントなデータを受け取ることができます。これにより、アナリストがアドホックなエクスポートから機密フィールドを除外し忘れるリスクを排除できます。
より迅速で信頼性の高いレポーティングにより、事象の発生からビジネス上の意思決定が行われる までの時間を短縮できます。前週ではなく前日のデータに基づいてレポートを作成できる組織は、コンバージョン率の低下やサポートチケットの急増といったパフォーマンス上の問題を、収益への悪影響が拡大する前に把握することができます。
データ変換が引き起こす課題とは?
- スキーマドリフト は、本番環境で最も多く見られる変換の障害モードです。ソースシステムがパイプラインチームへの通知なしにフィールド名を変更したり、新しいフィールドを追加したり、データ型を変更したりすると、変換ルールが気づかれないまま破綻します。破損したデータや欠損データが、誰も気づかないうちにウェアハウスに蓄積されていきます。ビジネス上のコストとして、売上が過小評価されたり解約率が過大評価されたりするレポートが、エラーが発見されるまで数日から数週間にわたって生成され続けることもあります。
- データ量のスケーリング は、徐々に顕在化する課題です。1か月分のデータでは問題なく動作していた変換処理が、3年分の履歴データに適用すると失敗やタイムアウトが発生し始めます。最初からスケールを考慮した変換ロジックを設計しない組織は、データ量が増大した際に高コストなパイプラインの再構築を余儀なくされます。そして、データ量は常に増え続けるものです。
- 変換ルールのガバナンスは、見過ごされがちな運用上の負担です。文書化されていないSQLスクリプト、スプレッドシートの数式、ツール固有の設定に分散した変換ロジックは、監査、テスト、引き継ぎが困難になります。変換ロジックをバージョン管理していないチームは、レポート期間ごとに指標が変動した理由を説明できなくなります。
データクレンジングとデータ検証は、変換プロセスに組み込む必要があり、独立した上流工程として扱うべきではありません。検証を省略すると、変換を通過した不正なデータが信頼できるように見えます。フォーマットは正しく、フィールド名も適切ですが、実際の値は誤っています。そのデータを基に行った下流の意思決定には、事後に発見しにくい隠れたリスクが伴います。
データ変換ツールはどのように評価すべきか
変換ツールは大きく3つのカテゴリに分類され、それぞれ異なるチーム体制やデータ環境に適しています。
- コードファーストフレームワークは、SQLまたはPythonベースのツールを活用し、変換ロジックをコードとして記述してバージョン管理し、ソフトウェアと同様にテストします。エンジニアリング体制が整っており、精緻な制御と監査性が求められるチームに最適です。ただし、要求されるスキルレベルが高いというトレードオフがあります。SQLに精通していないビジネスアナリストは、変換ロジックを独立して管理・変更することができません。
- ビジュアルETL・ELTプラットフォームは、変換ステップをコーディングではなく設定で行えるドラッグ&ドロップインターフェースを提供します。ビジネスアナリストが変換ロジックを担い、エンジニアリングリソースが限られているチームに最適です。ただし、複雑な変換における柔軟性が低下し、一部のツールではバージョン管理のサポートが限定的というトレードオフがあります。
- データプラットフォームへの変換機能の組み込みとは、ストレージとコンピュートとともにネイティブの変換機能を備えたクラウドデータウェアハウスや顧客データプラットフォームを指します。スタック内のツール数を最小限に抑えたい組織に最適です。データモデリング、データの標準化、リアルタイムのアクティベーションを同一プラットフォームで利用できる場合に特に効果を発揮し、パイプラインの複雑性とレイテンシの削減につながります。
カテゴリにかかわらず、以下の評価基準を適用してください。
- そのツールは変換ルールのバージョン管理とテストをサポートしているか?バージョン管理のない変換ロジックは、ガバナンス上のリスクとなります。
- スキーマの変更に適切に対応できるか、またはソースのスキーマ変更によってパイプラインが気づかないうちに停止するリスクはないか?
- 現在だけでなく、2年後の組織のデータ量にも対応できるスケーラビリティを備えているか?
- どのソースフィールドがどの出力フィールドを生成したかを示す、文書化されたデータ系譜マップを出力できるか?系譜は規制監査やデータ品質の問題解決に不可欠です。
- 大規模運用時の計算処理コストやツールの維持管理に要するエンジニアリング工数を含む、総所有コストはどの程度か?
適切なデータ変換アプローチの選び方
以下の意思決定フレームワークを参考に、自組織の状況に適した変換アプローチを選択してください。
エンジニアリングリソースが十分あり、データ量が数千万行を超える場合は、クラウドウェアハウス内のコードファーストELTフレームワークを選択してください。変換ロジックを最大限にコントロールでき、自動テストやピアレビューといったソフトウェアエンジニアリングの手法を適用できます。
チームがアナリスト主導でエンジニアリングサポートが限られており、データ量が中規模の場合は、ソースシステム向けのビルトインコネクタを備えたビジュアルETLプラットフォームを選択してください。スキルのハードルが下がり、エンジニアリングスプリントを待たずにアナリストが変換ロジックを繰り返し改善できます。
チャネル全体でパーソナライズ機能とリアルタイムアクティベーションを目的にお客様データを管理する場合は、変換、データ標準化、ID解決機能を内蔵した顧客データプラットフォームを選択してください。Adobe Experience Platformは、数十のソースから異なる形式でお客様データが届き、共通スキーマに基づいてリアルタイムで変換・標準化したうえで、重複なく分析とアクティベーションの両ユースケースに対応する必要があるエンタープライズレベルのシナリオに対応しています。これは、該当条件に当てはまる場合に評価する価値のある複数のエンタープライズグレードの選択肢の一つであり、あらゆるデータ変換ニーズに対するデフォルトの答えではありません。
規制上、未処理の個人識別情報(PII)を共有環境に取り込むことが禁止されている場合は、データのロード前に匿名化とマスクを実行するETLアーキテクチャを選択してください。
ツールの選定前に、3つの観点から変換要件を整理してください。第一に、ソースシステムの数と変更頻度です。これにより、スキーマの変動に対する耐性がどの程度必要かが決まります。第二に、ダウンストリームのコンシューマー数です。これにより、ガバナンスと系譜のドキュメンテーションに必要な水準が決まります。第三に、レイテンシ要件です。これにより、バッチ変換で対応可能か、ニアリアルタイム変換が必要かが決まります。
どのアプローチを選択する場合でも、最初のパイプライン実行からデータ品質管理のベストプラクティスを優先することが重要です。品質管理の仕組みを既存の変換レイヤーに後から追加することは、最初から組み込む場合と比べてはるかにコストがかかります。
よくある質問
データ変換とデータ統合の違いとは
データのロード前変換とロード後変換、どちらを選ぶべきか
データ変換はデータ品質にどのような影響を与えるか
データ変換を管理するためにチームに必要なスキルとは
データ変換はマーケティング分析においてどのように活用されるか
信頼性の高いデータ変換の基盤を構築することは、データチームにとって最も効果の高い投資のひとつです。チャネルをまたいでお客様データを統合し、組み込みの変換機能、ID解決、リアルタイムアクティベーションを活用する準備が整った組織は、Adobe Experience Platformの詳細を確認してください。
関連トピックス
https://business.adobe.com/fragments/resources/cards/thank-you-collections/rtcdp