Enterprise-KI hat ein Content-Problem
Unternehmen investieren zunehmend in Generative KI, Copilots, intelligente Suche und automatisierte Support-Erlebnisse. Und doch versuchen viele, diese Systeme mit fragmentierten PDFs, dupliziertem und veraltetem Wissen, isolierten Repositories, inkonsistenten Metadaten und Publishing-Workflows aus vergangenen Zeiten zu betreiben.
Das führt zu einem Problem, das viele KI-Initiativen von Anfang an unterschätzen. KI-Systeme sind nur so vertrauenswürdig wie die Inhalte, die sie abrufen.
Forbes bezeichnete Knowledge Management kürzlich als „das Stiefkind der Tech-Welt“ – und argumentierte, es könnte die Rettung der KI sein. Diese Einschätzung trifft die Dringlichkeit auf den Punkt.
Die meisten Diskussionen rund um Enterprise-KI drehen sich nach wie vor um Modelle, Copilots und Retrieval-Augmented-Generation-Architekturen (RAG). Doch die eigentliche operative Herausforderung liegt weit früher im Prozess. Enterprise-KI ist auf verwalteten, strukturierten und wiederverwendbaren Content angewiesen, dem systemübergreifend, teamübergreifend und über alle Ausgabekanäle hinweg vertraut werden kann.
Das Thema wird zunehmend dringlicher, da sich Produktdokumentation von einem nachgelagerten Support-Artefakt zu einer zentralen operativen Ebene entwickelt, die Self-Service für die Kundschaft, Onboarding, Support-Automatisierung, Wissensabruf, Compliance-Workflows und personalisierte digitale Erlebnisse unterstützt.
Der operative Druck ist im gesamten Unternehmen bereits deutlich spürbar. Eine Studie, beauftragt von Adobe und durchgeführt von S&P Global, ergab, dass 87 % der Befragten Schwierigkeiten haben, Content über seinen gesamten Lebenszyklus hinweg zu verwalten, während 68 % mit zu vielen isolierten Anwendungen und Systemen zu kämpfen haben. Diese operativen Ineffizienzen schaffen genau die Art fragmentierter Umgebungen, die die Retrieval-Qualität und Governance von Enterprise-KI untergraben.
Unternehmen, die technische Dokumentation weiterhin als statisches Ausgabeformat behandeln, riskieren, dass ihre KI-Initiativen dieselben Schwachstellen übernehmen, die bereits in ihren Content-Prozessen bestehen – duplizierte Informationen, veraltetes Wissen, inkonsistente Terminologie, mangelnde Auffindbarkeit und eine fragmentierte Dokumentations-Governance.
Unternehmen, die Enterprise-KI erfolgreich einsetzen, gehen grundlegend anders mit ihrer Dokumentation um. Sie bauen Content-Ökosysteme auf, die auf KI ausgerichtet sind – konzipiert nicht nur für menschliche Lesende, sondern auch für Retrieval-Systeme, semantische Suche, Automatisierungs-Pipelines und KI-gesteuerte Erlebnisse.
Warum KI-Systeme bei der Unternehmensdokumentation an ihre Grenzen stoßen
Große Sprachmodelle (LLMs) liefern beeindruckende Ergebnisse, wenn sie auf verlässlichem Unternehmenswissen basieren. Das Problem: Viele Dokumentationsumgebungen in Unternehmen wurden von Anfang an nicht für moderne Retrieval-Architekturen konzipiert.
Veraltete Dokumentationssysteme enthalten häufig überlappende PDFs, doppelte Verfahrensbeschreibungen in verschiedenen Word-Dokumenten, inkonsistente Namenskonventionen und Ordnerstrukturen, veraltete Inhalte, unkontrollierte Kopien, die als finale Versionen weitergegeben werden, voneinander getrennte Repositories sowie fragmentierte Verantwortungsmodelle. Menschen können solche Inkonsistenzen oft durch Erfahrung und Kontext überbrücken. KI-Systeme hingegen nicht.
Immer mehr Unternehmen setzen auf DITA-basiertes strukturiertes Authoring und Component-Content-Management-Systeme (CCMSs), um diese grundlegenden Lücken zu schließen – denn die Qualität des Retrievals hängt davon ab, wie Inhalte erstellt und verwaltet werden, nicht nur davon, wie sie abgerufen werden.
Sobald Unternehmen KI-gestützte Support-Systeme und KI-Copilots einsetzen, verstärken sich diese Schwachstellen. Retrieval-Systeme haben Schwierigkeiten, verlässliche Informationen zu identifizieren. KI-generierte Antworten können veraltete und aktuelle Hinweise vermischen. Ähnliche Themen mit inkonsistenter Terminologie führen zu Mehrdeutigkeit. Lange Dokumente enthalten oft schlecht segmentierte Informationen, die die Präzision des Retrievals beeinträchtigen.
Das führt nicht nur zu Effizienzverlusten – sondern vor allem zu einem schwindenden Vertrauen in die Antworten selbst.
Diese Herausforderung erklärt, warum viele Unternehmen ihre KI-Initiativen zunehmend auf Governance, Retrieval-Qualität, Content-Architektur und semantische Organisation ausrichten. Die Leistungsfähigkeit von KI hängt immer stärker von der Qualität des Content-Ökosystems ab, das sie speist.
Der operative Druck ist bereits beträchtlich. Laut einer von Adobe in Auftrag gegebenen Forrester-Studie gaben 64 % der Unternehmen an, Schwierigkeiten bei der Bewältigung moderner Content-Erstellungsanforderungen zu haben, während 68 % die mangelnde Content-Wiederverwendung als zentrale Herausforderung nannten. Es handelt sich längst nicht mehr um isolierte Dokumentationsprobleme. Sie beeinträchtigen zunehmend die Zuverlässigkeit, Skalierbarkeit und Vertrauenswürdigkeit unternehmensweiter KI-Systeme.
KI kann maßgebliche Inhalte nicht von redundanten unterscheiden.
Unkontrollierte Duplikation zählt zu den kritischen Schwachstellen in Enterprise-Dokumentationsumgebungen.
Mehrere Versionen ähnlicher Prozesse, duplizierte Produktinformationen in verschiedenen Repositories, widersprüchliche Terminologie und unkontrollierte lokale Kopien verursachen operative Reibungspunkte, noch bevor KI überhaupt ins Spiel kommt. Doch wenn unternehmensweite KI-Systeme versuchen, Wissen aus diesen Umgebungen abzurufen, verschärft sich das Problem erheblich.
KI-Systeme können grundsätzlich nicht bestimmen, welche Version eines Prozesses maßgeblich ist, welche Produktspezifikation aktuell ist oder welcher Content-Instanz gegenüber einer anderen vertraut werden soll. Ohne geregelte Single-Source-of-Truth-Workflows riskieren Retrieval-Systeme, widersprüchliche oder veraltete Informationen anzuzeigen.
Deshalb setzen moderne Strategien für strukturierte Inhalte zunehmend auf zentralisierte Content-Governance, kontrollierte Wiederverwendung und maßgebliche Publishing-Pipelines. Unternehmen, die KI-Systeme einsetzen, benötigen Dokumentationsarchitekturen, die Konsistenz über alle Ausgabekanäle hinweg gewährleisten.
Laut einer von Adobe in Auftrag gegebenen IDC-Studie konnten Unternehmen, die Adobe Experience Manager Guides nutzen, erhebliche operative Vorteile durch zentralisiertes Content-Management, Wiederverwendung und Versionskontrolle erzielen – darunter gesteigerte Produktivität, höhere Konsistenz und bessere Kundenerlebnisse.
Moderne DITA-Content-Management-Praktiken setzen genau hier an. Durch Single-Sourcing – das einmalige Erstellen von Inhalten und deren Wiederverwendung in verschiedenen Ausgaben – beseitigen Unternehmen die Duplikation, die Retrieval-Systeme verwirrt. Content-Wiederverwendung ist zugleich ein Effizienzgewinn und eine KI-Governance-Strategie.
Dies deckt sich mit übergreifenden Branchenerkenntnissen. Forrester stellte zudem fest, dass 69 % der Befragten der Ansicht waren, flexible XML-basierte Content-Strukturen verbesserten die Wiederverwendungs- und Syndikationsmöglichkeiten – was die wachsende Bedeutung strukturierter Content-Architekturen im Content-Management moderner Unternehmen unterstreicht.
Legacy-Dokumentationsstrukturen wurden für Menschen entwickelt, nicht für Retrieval-Systeme.
Klassische Dokumentationsumgebungen wurden für lineares Lesen optimiert – nicht für semantisches Retrieval.
Jahrzehntelang veröffentlichten Unternehmen umfangreiche, monolithische Handbücher, seitenlange PDFs und dokumentenzentrierte Wissensdatenbanken für die sequenzielle Nutzung durch Menschen. Diese Modelle dienten klassischen Publishing-Workflows durchaus gut – für KI-Retrieval-Architekturen jedoch stellen sie erhebliche Herausforderungen dar.
KI-Systeme verarbeiten Informationen grundlegend anders als Menschen. Sie rufen kleinere semantische Fragmente ab, bewerten Relevanz dynamisch und fügen Antworten aus verschiedenen Kontextquellen zusammen.
Das verändert die operativen Anforderungen an die Unternehmensdokumentation grundlegend.
Warum ein CCMS die Grundlage KI-fähiger Dokumentation ist
Umfangreiche monolithische Dokumente enthalten häufig übermäßig viel Kontext, doppelte oder veraltete Informationen, inkonsistente Strukturen und schwache semantische Grenzen. Retrieval-Systeme haben Schwierigkeiten, die relevantesten Inhalte in übergroßen Dokumentationsblöcken zu isolieren.
Modulare, strukturierte Inhalte hingegen ermöglichen es Unternehmen, Informationen in wiederverwendbare, semantisch bedeutsame Komponenten aufzuteilen – leichter abzurufen, zu personalisieren, zu verwalten und kanalübergreifend wiederzuverwenden.
Das ist einer der Gründe, warum strukturiertes Authoring und Component Content Management Systeme (CCMSs) zunehmend zu grundlegenden Technologien für KI-fähige Unternehmen werden. Ein CCMS – wie Adobe Experience Manager Guides – ist eine spezialisierte Plattform, die strukturierte, wiederverwendbare Inhalte auf Themenebene statt auf Dokumentenebene verwaltet. Im Gegensatz zu einem klassischen CMS setzt ein CCMS auf Governance, Versionierung und strukturierte Authoring-Workflows, die sowohl menschliches Publishing als auch KI-Retrieval in Unternehmensgröße unterstützen.
Die neue Checkliste für KI-fähigen Content
KI-fähige Dokumentationsumgebungen entstehen nicht allein durch Chat-Schnittstellen oder KI-Integrationen. Sie erfordern konsequente Content-Prozesse, die zuverlässiges Retrieval, Governance, Wiederverwendung, Skalierbarkeit und semantische Konsistenz gewährleisten.
Die folgenden Architekturprinzipien werden für Unternehmen, die vertrauenswürdige KI-Ökosysteme aufbauen, immer unverzichtbarer.
1. Strukturiertes Authoring und modulare Inhalte
KI-Systeme entfalten ihr Potenzial, wenn Unternehmensinhalte modular, semantisch organisiert und wiederverwendbar sind.
Strukturiertes Authoring – ob über DITA XML, themenbasiertes Schreiben oder andere strukturierte Content-Frameworks – ermöglicht es Unternehmen, modulare Content-Komponenten zu erstellen, die sich dynamisch für verschiedene Produkte, Kanäle, Erlebnisse und Zielgruppen zusammenstellen lassen. Das bildet die Grundlage des modernen Component Content Managements und wird für Unternehmen, die KI-bereit sein wollen, immer unverzichtbarer. Statt isolierter Dokumente verwalten Unternehmen damit wiederverwendbare Wissens-Assets.
„Wenn wir Unternehmen dabei helfen, große Mengen an Enterprise-Content zu migrieren und zu strukturieren, geht es längst nicht mehr nur um Effizienz beim Publizieren. Unternehmen fragen sich heute, ob ihre Inhalte KI-gestütztes Retrieval, semantische Suche, Personalisierung, Compliance und künftige Automatisierungsinitiativen im benötigten Umfang unterstützen können“, so Bernard Aschwanden, CEO und Mitgründer von WritemoreAI, auf LinkedIn.
Die operativen Vorteile sind beträchtlich.
Erstens verbessert strukturiertes Authoring die Konsistenz. Gemeinsam genutzte Content-Komponenten lassen sich einmalig aktualisieren und für mehrere Ausgaben wiederverwenden – das reduziert Redundanzen und senkt das Risiko widersprüchlicher oder veralteter Informationen.
Zweitens verbessert es die Abrufqualität. KI-Systeme können kleinere, semantisch kohärente Themen präziser abrufen.
Drittens unterstützt es die Personalisierung im benötigten Umfang. Strukturierter Content ermöglicht es Unternehmen, Erlebnisse für verschiedene Zielgruppen, Produktvarianten, Regionen und Kanäle dynamisch zusammenzustellen – ohne Inhalte zu duplizieren.
Forrester Research belegt, dass Unternehmen strukturiertes Content-Management zunehmend als unverzichtbar für Personalisierung, Skalierbarkeit und Omni-Channel-Content-Lieferung betrachten.
Dieselbe Studie ergab außerdem, dass 57 % der Unternehmen erwarteten, mit strukturierten Content-Ansätzen den ROI ihrer Content-Strategie zu steigern. Mehr als 80 % berichteten nach der Einführung strukturierter Content-Management-Praktiken von einem Rückgang regulatorischer, reputationsbezogener, finanzieller und personalbezogener Risiken.
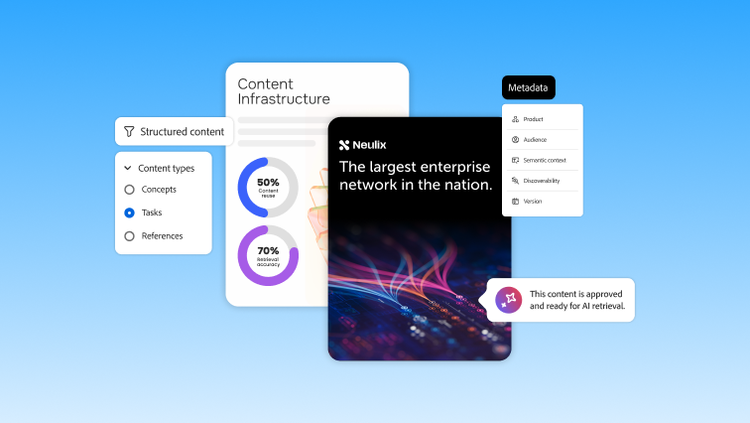
2. Metadaten für die semantische Suche.
Metadaten entwickeln sich rasant zu einer der wichtigsten operativen Ebenen in der Enterprise-KI.
Lange Zeit galten Metadaten in vielen Unternehmen lediglich als administrativer Overhead. Heute stehen sie im Mittelpunkt von Präzisionssuche, Auffindbarkeit, Personalisierung, Governance und KI-Orchestrierung.
Moderne KI-Systeme sind stark auf Metadaten angewiesen, um Content-Beziehungen, Zielgruppenrelevanz, Lebenszyklusstatus, regionale Anwendbarkeit, Produktzuordnungen, Compliance-Anforderungen und semantischen Kontext zu erfassen.
Unternehmen ohne eine konsequente Metadaten-Strategie kämpfen häufig mit inkonsistenten Sucherlebnissen, mangelhafter Abrufqualität, schwacher Personalisierung und fragmentierten Content-Prozessen.
Die Qualität von Metadaten beeinflusst zunehmend, wie KI-Systeme in Unternehmen Informationen bewerten, abrufen und kontextualisieren. Ohne konsistente Metadaten-Governance entstehen semantische Unklarheiten, die sowohl die Suche für Menschen als auch KI-generierte Antworten beeinträchtigen.
Leistungsstarke Metadaten-Architekturen verbessern das Verständnis von Unternehmenswissen – sowohl für Menschen als auch für Maschinen.
Dazu zählen die folgenden Aktionen:
- Produkt-Metadaten
- Zielgruppen-Metadaten
- Regionale und rechtliche Anwendbarkeit
- Lifecycle-Status
- Taxonomie-Abgleich
- Semantische Klassifikation
- Beziehungs-Mapping
- Versions-Lineage
In strukturierten Content-Management-Umgebungen – besonders solchen auf DITA-Basis – werden Metadaten nicht nachträglich ergänzt, sondern direkt beim Authoring eingebettet: durch strukturierte Prolog-Elemente, bedingte Attribute und Subject-Schemes. Dadurch sind DITA-Inhalte von Natur aus metadatenreicher und KI-bereit als unstrukturierte Dokumentation – und deutlich besser für KI-Abruf-Architekturen geeignet.
Je mehr Unternehmen auf KI-gestützte Support-Systeme und semantische Sucherlebnisse setzen, desto unmittelbarer hängt die Qualität von Metadaten mit der Vertrauenswürdigkeit der KI zusammen.
3. Intelligentes Chunking für die KI-Verarbeitung.
Die Chunking-Strategie wird bei KI-bereiter Dokumentation häufig unterschätzt.
KI-Abrufsysteme verarbeiten selten vollständige Handbücher oder umfangreiche Dokumente. Stattdessen rufen sie kleinere Content-Fragmente ab, die auf maximale kontextuelle Relevanz ausgerichtet sind.
Mangelhaftes Chunking beeinträchtigt die Abrufqualität – oft unbemerkt.
Zu große Chunks verringern die Abrufpräzision und bringen unnötigen Kontext mit sich. Zu kleine Chunks können hingegen semantische Bedeutung verlieren oder die prozedurale Kontinuität unterbrechen.
Intelligentes Chunking erfordert, dass Unternehmen folgende Aspekte sorgfältig bedenken:
- Semantische Grenzen
- Prozedurale Kohäsion
- Thematische Granularität
- Wiederverwendbare Inhaltseinheiten
- Kontexterhaltung
- Retrieval-Optimierung
Genau hier entfalten strukturierte Inhaltsmodelle ihren vollen Mehrwert.
Gut konzipierte, modulare Themen unterstützen KI-Retrieval-Architekturen auf natürliche Weise – sie gliedern Konzepte, Aufgaben, Referenzen, Warnhinweise, Fehlerbehebungsanleitungen und Prozessschritte bereits in kohärente Einheiten.
Führende Unternehmen erkennen zunehmend: Chunking ist kein reines Konfigurationsproblem für den Datenabruf – es ist eine Disziplin der Content-Architektur.
„Große Sprachmodelle lesen Dokumentation nicht so wie Menschen. Sie rufen Fragmente, Beziehungen und Kontextfenster ab. Das bedeutet, dass Unternehmen Inhalte von Grund auf für Retrieval-Präzision konzipieren müssen – nicht nur für effizientes Publizieren“, schlussfolgerte Aschwanden.
4. Stabile IDs, Referenzen und Rückverfolgbarkeit.
Vertrauenswürdige Unternehmens-KI setzt nachverfolgbares Unternehmenswissen voraus.
Wenn Unternehmen KI-gestützte Support-Erlebnisse, interne Copilots und automatisierte Assistenzsysteme einsetzen, gewinnt die Fähigkeit, generierte Antworten auf autoritative Quellen zurückzuverfolgen, zunehmend an Bedeutung.
Stabile Bezeichner und verwaltete Referenzen helfen Unternehmen dabei, Folgendes zu gewährleisten:
- Nachverfolgbarkeit von Zitaten
- Versionsbewusstsein
- Auditierbarkeit
- Compliance-Nachweisbarkeit
- Content-Herkunft
- Systemübergreifende Konsistenz
Besonders in regulierten Branchen ist das entscheidend: Dort müssen Unternehmen die Herkunft und Gültigkeit operativer Vorgaben lückenlos nachweisen können.
Stabile Referenzen verbessern außerdem die Abrufqualität – sie helfen KI-Systemen dabei, verwandte Inhalte in verschiedenen Publishing-Umgebungen konsistent zuzuordnen.
Je weiter sich KI in Unternehmen verbreitet, desto wichtiger werden Erklärbarkeit und Rückverfolgbarkeit als operative Anforderungen.
5. Versionskontrolle und autorisierte Publishing-Workflows.
KI-Systeme verstärken bestehende Governance-Schwachstellen.
Fehlen in der Unternehmensdokumentation strukturierte Freigabe-Workflows, kontrollierte Publishing-Prozesse, Versionssynchronisierung oder Governance-Aufsicht, werden diese Lücken durch KI-generierte Erlebnisse sichtbar.
Unternehmen, die KI-Systeme einsetzen, müssen daher in folgenden Bereichen strikte operative Disziplin wahren:
- Genehmigungs-Workflows
- Publishing-Governance
- Versionskontrolle
- Aktualität der Inhalte
- Prüfprozesse
- Rollenbasierte Berechtigungen
- Prüfbarkeit
Das gewinnt besondere Relevanz, wenn Unternehmen KI-gestützte Unterstützung in regulierten oder kundennahen Umgebungen einsetzen – denn veraltete oder widersprüchliche Informationen können Compliance-, Reputations- und Rechtsrisiken auslösen.
Gesteuerte Workflows stellen sicher, dass KI-Systeme aktuelle, freigegebene und verlässliche Informationen abrufen – und keine veralteten oder unvollständigen Inhalte.
Das ist besonders wichtig, wenn die Dokumentation kundennahe Erlebnisse, regulatorische Vorgaben, Produkt-Onboarding oder betriebliche Abläufe unterstützt.
Strukturierte Content-Management-Systeme liefern zunehmend die Governance-Grundlagen, die diese Workflows auf Unternehmensebene erfordern.
6. Source-of-Truth-Architekturen über alle Kanäle hinweg.
Moderne Unternehmen veröffentlichen Inhalte heute selten noch an einem einzigen Ort.
Produktdokumentation treibt heute Websites, Support-Portale, Onboarding-Systeme für die Kundschaft, Wissensdatenbanken, APIs, mobile Erlebnisse, intelligente Suchsysteme, Lernplattformen und KI-gestützte Assistenten an.
Ohne zentrale Governance und wiederverwendbare Quellinhalte duplizieren Unternehmen Informationen häufig kanalübergreifend. Im Laufe der Zeit entstehen so Inkonsistenzen, operative Ineffizienzen und ein erhöhtes Compliance-Risiko.
KI-bereite Unternehmen setzen stattdessen auf Architekturen mit einer einzigen verlässlichen Informationsquelle, aus der strukturierte, governance-konforme Inhalte aus zentralen Repositories dynamisch zusammengestellt und kanalübergreifend bereitgestellt werden.
Dieser Ansatz unterstützt:
- Schnellere Aktualisierungen
- Höhere Konsistenz
- Bessere Governance
- Verbesserte Personalisierung
- Weniger Redundanzen
- Besser skalierbare Betriebsabläufe
Zudem schafft dieser Ansatz eine solide Grundlage für KI-Systeme im Unternehmensbereich, die auf verlässlichem, synchronisiertem Wissen basieren.
Warum KI-fähige Content-Architekturen klassische Dokumentationsprozesse übertreffen
Unternehmen, die ihre Content-Prozesse modernisieren, stellen häufig fest, dass KI-Bereitschaft und operative Exzellenz eng miteinander verknüpft sind.
Dieselben Prinzipien strukturierter Inhalte, die die Abrufqualität verbessern, steigern gleichzeitig die Wiederverwendbarkeit, Übersetzungseffizienz, Governance, Personalisierung, Skalierbarkeit und Veröffentlichungskonsistenz.
IDC-Forschungsergebnisse belegen, dass Unternehmen, die Adobe Experience Manager Guides einsetzen, erhebliche Verbesserungen in den Bereichen Content-Management-Effizienz, Content-Wiederverwendung, Produktivität und operative Skalierbarkeit verzeichnen.
Diese Vorteile gewinnen zunehmend an Bedeutung, da Content-Umgebungen selbst zu operativen Engpässen geworden sind. S&P Global Research stellte zudem weit verbreitete Reibungspunkte durch isolierte Systeme, fragmentierte Workflows, unklare Verantwortlichkeiten und inkonsistente Zusammenarbeit fest – allesamt Faktoren, die die Wissensqualität im Unternehmen und die KI-Bereitschaft direkt beeinflussen.
Forrester-Forschungsergebnisse zeigen gleichermaßen, dass Unternehmen, die strukturierte Content-Management-Ansätze einsetzen, von höherer Content-Konsistenz, stärkeren Personalisierungsfähigkeiten, Omni-Channel-Bereitstellung und einem reduzierten operativen Risiko profitieren.
Diese Konvergenz ist für viele Unternehmen bedeutsamer, als ihnen bewusst ist.
Unternehmen modernisieren ihre Dokumentationsumgebungen längst nicht mehr nur, um die Publishing-Effizienz zu steigern. Der eigentliche Antrieb: KI-Systeme im Unternehmensbereich sind heute auf vertrauenswürdige, strukturierte und semantisch kontrollierte Content-Ökosysteme angewiesen.
Schnellere KI-Implementierung bei geringerem operativem Risiko
Unternehmen mit strukturierten und verwalteten Content-Umgebungen können unternehmensweite KI-Initiativen wirkungsvoller in die Praxis umsetzen.
Retrieval-Systeme arbeiten zuverlässiger, wenn Inhalte modular und semantisch strukturiert sind. Metadaten verbessern die Auffindbarkeit und stärken die Retrieval-Genauigkeit. Eine konsequente Versionsverwaltung minimiert das Risiko, veraltete Informationen bereitzustellen. Kontrollierte Workflows steigern die Vertrauenswürdigkeit.
Gemeinsam reduzieren diese operativen Funktionen den Aufwand bei der KI-Implementierung und senken das Risiko fehlerhafter oder inkonsistenter Ausgaben.
Das ist besonders relevant für Unternehmen in regulierten Branchen, in denen Inhaltsgenauigkeit und Nachvollziehbarkeit unerlässlich sind.
Bessere Kundenerlebnisse durch verlässliches Retrieval
Die Kundschaft erwartet zunehmend sofortige, kontextbezogene und verlässliche Antworten.
KI-gestützte Support-Systeme, intelligente Sucherlebnisse und unternehmensweite Copilots werden immer mehr zu einem festen Bestandteil des modernen Customer-Experience-Stapels.
Doch diese Erlebnisse überzeugen nur dann, wenn die zugrundeliegende Wissensarchitektur vertrauenswürdig ist.
Dieses Vertrauen hängt zunehmend davon ab, ob Unternehmen autorisierte Quellinhalte, einheitliche Governance, synchronisierte Updates und retrieval-fähige Architekturen über alle Bereitstellungskanäle hinweg aufrechterhalten können.
Unternehmen mit strukturierten, wiederverwendbaren und semantisch verwalteten Dokumentationsumgebungen sind besser aufgestellt, um Folgendes bereitzustellen:
- Schnellere Support-Erlebnisse
- Verbesserter Self-Service
- Schnellere Akquise
- Genauere Retrieval-Ergebnisse durch KI
- Stärkere Personalisierung
- Konsistente Omni-Channel-Erlebnisse
Damit werden Content-Operationen direkt mit der Customer-Experience-Strategie verknüpft.
Skalierbare Personalisierung ohne Content-Duplizierung
Personalisierung in unternehmensweitem Maßstab erfordert einen modularen Aufbau.
Unternehmen, die mehrere Produkte, Regionen, regulatorische Rahmenbedingungen, Sprachen oder Kundentypen bedienen, können Personalisierung nicht effizient skalieren, wenn sie auf redundante, statische Dokumentation zurückgreifen.
Strukturierte Inhaltsmodelle ermöglichen Unternehmen, mithilfe wiederverwendbarer Inhaltskomponenten – zentral gesteuert über einheitliche Workflows – dynamisch zielgerichtete Erlebnisse zusammenzustellen.
Das reduziert Redundanzen und steigert gleichzeitig die Agilität.
Dieselbe strukturierte Architektur, die Omni-Channel-Publikation und Wiederverwendung von Dokumentation unterstützt, verbessert zugleich die Qualität des KI-Abrufs – durch konsistente Inhalte über alle Varianten hinweg.
Unternehmen, die mit KI gewinnen, steuern Content grundlegend anders
Enterprise-KI zwingt Unternehmen dazu, Dokumentation grundlegend neu zu denken.
Lange Zeit galt Dokumentation als nachgelagerte operative Pflicht – etwas, das erst nach der Produktentwicklung entstand.
Heute fungiert Dokumentation zunehmend als operative Intelligenz: Sie treibt Supportsysteme, Onboarding-Erlebnisse, semantisches Retrieval, intelligente Suche, Personalisierungs-Engines, Compliance-Workflows und KI-gestützte Assistenz an.
„Die meisten Unternehmen betrachten Dokumentation immer noch als ein Publishing-Problem. KI zeigt jedoch, dass es sich eigentlich um ein Problem der Wissensarchitektur handelt. Wenn euer Content fragmentiert, redundant oder nicht mit einer Governance-Struktur verbunden ist, werden eure KI-Systeme dieselben Schwächen in großem Maßstab übernehmen“, so Aschwanden.
Dieser Wandel verändert die strategische Bedeutung strukturierter Inhalte grundlegend.
Unternehmen, die vertrauenswürdige Enterprise-KI-Systeme aufbauen, werden zunehmend Folgendes benötigen:
- Gesteuerte Content-Prozesse
- Structured authoring
- Semantische Metadaten
- Modulare, wiederverwendbare Themen
- Gesteuerte Workflows
- Publishing-Architekturen als Single Source of Truth
- Nachvollziehbare Referenzen
- Retrieval-optimiertes Content-Design
Der Wettbewerbsvorteil wird nicht allein Unternehmen mit den größten Modellen oder den sichtbarsten KI-Initiativen gehören.
Die Zukunft gehört den Unternehmen mit dem vertrauenswürdigsten Enterprise-Wissen.
KI-Bereitschaft beginnt lange vor dem Modell
Viele Unternehmen betrachten Enterprise-KI-Initiativen nach wie vor hauptsächlich als Technologieprojekte.
Dabei hängt der Erfolg von KI-Systemen maßgeblich von vorgelagerten Entscheidungen zur Content-Architektur ab.
Strukturiertes Authoring, Metadaten-Governance, intelligentes Chunking, stabile Referenzen, wiederverwendbare Content-Modelle und Single-Source-of-Truth-Workflows wirken sich direkt auf Abrufqualität, Personalisierung, Erklärbarkeit, Skalierbarkeit und das Vertrauen im Unternehmen aus.
Mit zunehmender Verbreitung von Enterprise-KI sind Unternehmen, die ihre Dokumentationsökosysteme modernisieren, deutlich besser aufgestellt, um verlässliche KI-Erlebnisse in die Praxis umzusetzen.
Die Zukunft der Enterprise-KI lässt sich nicht allein auf Modellen aufbauen.
Ihr Fundament bildet reguliertes, strukturiertes und semantisch organisiertes Enterprise-Wissen.
Checkliste für KI-bereiten Enterprise-Content
Die folgende Checkliste bietet Unternehmen einen praktischen Bewertungsrahmen, um die Dokumentationsreife für Enterprise-KI-Initiativen einzuschätzen.
Struktur und Modularität
- Wird Content in wiederverwendbaren, strukturierten Komponenten erstellt – wie DITA-Themen – und nicht in monolithischen Dokumenten?
- Lässt sich Content dynamisch über verschiedene Kanäle, Produkte und Zielgruppen hinweg zusammenstellen?
- Sind semantische Themengrenzen klar definiert?
- Ist doppelter Content in allen Repositorys auf ein Minimum reduziert?
- Können einzelne Themen unabhängig aktualisiert werden, ohne ganze Dokumente neu schreiben zu müssen?
Metadaten und Taxonomie
- Wird Content konsequent mit Produkt-, Zielgruppen-, Lifecycle- und regionalen Metadaten getaggt?
- Bleibt die Taxonomie über alle Repositorys und Bereitstellungskanäle hinweg konsistent?
- Können KI-Systeme Beziehungen zwischen Content-Assets zuverlässig erkennen?
- Werden Metadatenstandards zentral verwaltet?
- Wird Content mit semantischen Klassifikationen angereichert, die die Auffindbarkeit verbessern?
Retrieval und Chunking
- Ist der Content für Retrieval-Systeme optimiert – und nicht nur für lineares Lesen?
- Sind Content-Chunks semantisch kohärent und kontexterhaltend?
- Können Retrieval-Systeme verlässliche Antworten effizient isolieren?
- Sind prozedurale Themen für die KI-Verarbeitung angemessen segmentiert?
- Ist die Chunking-Strategie auf eine wiederverwendbare Content-Architektur ausgerichtet?
Governance und Rückverfolgbarkeit
- Werden verbindliche Publishing-Workflows konsequent eingehalten?
- Lassen sich generierte KI-Antworten auf verwaltete Quellinhalte zurückverfolgen?
- Sind Versionierung und Freigaben über alle Bereitstellungskanäle hinweg synchronisiert?
- Sind Prüfbarkeit und Compliance-Anforderungen in die Content-Prozesse integriert?
- Werden stabile Bezeichner für alle wiederverwendbaren Content-Komponenten konsistent gepflegt?
Source-of-Truth-Betrieb
- Pflegt die Organisation zentral verwalteten, wiederverwendbaren Quell-Content?
- Werden lokale Kopien und nicht verwaltete Duplikate auf ein Minimum reduziert?
- Werden Aktualisierungen konsistent über alle Erlebnisse und Plattformen hinweg verteilt?
- Können Content-Verantwortliche eindeutig die maßgebliche Version von Informationen identifizieren?
- Wird die Governance über alle Veröffentlichungskanäle hinweg aufrechterhalten?
KI-Bereitschaft
- Nutzt die Organisation ein DITA-CCMS oder eine Plattform für strukturiertes Authoring, die reguliertes Publishing, Versionskontrolle und abrufoptimiertes Content-Design unterstützt?
- Können unternehmensweite KI-Systeme maßgebliche Inhalte von veralteten unterscheiden?
- Ist die Dokumentation von Grund auf abrufoptimiert?
- Sind Inhalte so strukturiert, dass sie Nachvollziehbarkeit und vertrauenswürdige KI-Antworten unterstützen?
- Können KI-Systeme modulare Inhalte mit ausreichend Kontext und Präzision abrufen?
- Unterstützt die Dokumentationsarchitektur skalierbare Personalisierung, Automatisierung und semantische Suche?