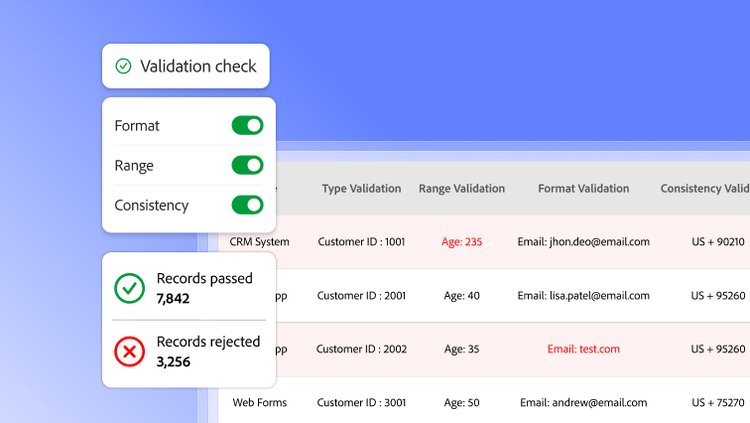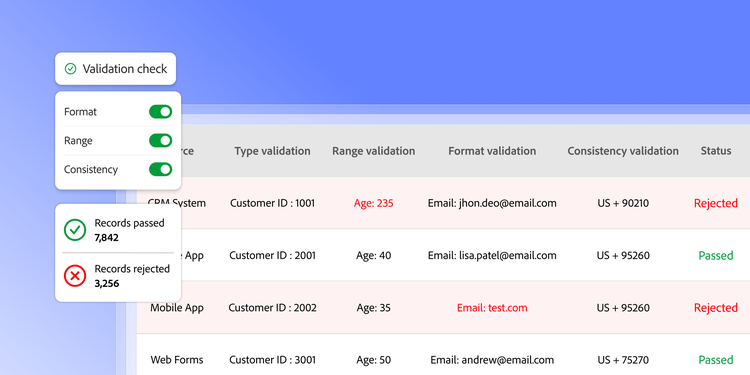
Les données erronées passent inaperçues. En silence, elles faussent les rapports, compromettent les pipelines en aval et sapent la confiance dans toutes les décisions qui en découlent. La validation des données est le contrôle systématique qui détecte ces problèmes avant qu’ils s’accumulent.
Cet article aborde les points suivants :
- Qu’est-ce que la validation des données ?
- Pourquoi la validation des données est-elle essentielle aux décisions métier ?
- Quelles sont les principales techniques de validation des données ?
- Comment les processus de validation des données fonctionnent-ils étape par étape ?
- Comment les organisations peuvent-elles choisir et mettre en œuvre une approche de validation ?
- Créer des pipelines de données plus fiables
Définition de la validation des données
La validation des données est le processus qui vérifie que les données respectent des règles prédéfinies avant d’entrer dans un système ou d’orienter une décision. Ces règles portent sur le format, la complétude, la plage de valeurs et la cohérence. Lorsqu’un champ de date accepte « 13/32/2024 » sans signaler d’anomalie, il s’agit d’un échec de validation, et chaque enregistrement en aval de ce champ contient désormais un défaut.
Toutes les équipes qui manipulent des données se confrontent à la validation, qu’elles en soient conscientes ou non. Qu’il s’agisse d’importer un export GRC, de charger une réponse d’API dans un entrepôt de données ou d’examiner un flux d’audience tiers, chacune s’appuie sur des contrôles de validation pour détecter les erreurs à la source. Le point commun est que chaque transfert introduit un risque : la définition de « valide » pour le système émetteur peut différer des exigences du système récepteur.
La validation s’impose à trois moments précis. Premièrement, lors de la première entrée des données dans un système. Deuxièmement, lors de leur transfert entre systèmes au cours d’une transformation des données, où les incompatibilités de format et les différences d’encodage sont fréquentes. Troisièmement, lors de leur agrégation à des fins de reporting, où des valeurs manquantes ou des définitions de champs incohérentes peuvent fausser silencieusement les totaux et les moyennes. Chaque transfert représente un point de vulnérabilité où les erreurs peuvent se propager en l’absence de point de contrôle.
Il est utile de distinguer la validation des données du nettoyage des données. La validation détermine si une donnée enfreint une règle. Le nettoyage corrige ou supprime l’enregistrement concerné. La validation répond à la question « Cette donnée est-elle acceptable ?», tandis que le nettoyage répond à « Comment la corriger ?» Ces deux opérations s’inscrivent dans un workflow de gestion de la qualité des données plus large, mais elles servent des objectifs différents et interviennent à des étapes distinctes.
À retenir : La validation est un point de contrôle. Elle détermine si les données sont aptes à progresser, sans intervenir sur leur correction.
Pourquoi la validation des données est-elle indispensable aux décisions métier ?
En bout de chaîne, les décisions ne sont fiables qu’à la hauteur des données qui les alimentent. Prenons l’exemple d’un modèle de segmentation client construit sur des enregistrements dont 15 % des adresses e-mail sont incorrectes. Les segments obtenus incluront des contacts injoignables, gaspillant le budget de campagne sur des personnes qui ne recevront jamais le message et ne convertiront pas davantage. Le modèle peut sembler statistiquement solide, mais ses résultats sont inexploitables en pratique.
- La validation réduit les coûts de reprise. Les erreurs détectées lors de l’ingestion des données sont peu coûteuses à corriger. Un code postal invalide signalé lors d’un chargement par lots est mis en quarantaine en quelques secondes. La même erreur, découverte après la distribution d’un rapport à la direction, impose une nouvelle analyse, une communication corrective et un travail de rétablissement de la confiance. Le coût en temps et en crédibilité d’une erreur détectée tardivement dépasse largement celui d’une vérification réalisée en amont.
- La conformité réglementaire repose sur des données validées. Des référentiels tels que le Règlement général sur la protection des données (RGPD) et le California Consumer Privacy Act (CCPA) exigent que les informations personnelles soient exactes et à jour. Des enregistrements non validés contenant des indicateurs de consentement obsolètes ou des identifiants incorrects exposent l’organisation à des risques réglementaires que les audits ne manqueront pas de détecter. Les organisations qui recourent à des techniques d’anonymisation des données pour protéger les informations personnelles ont toujours besoin d’enregistrements sources validés : anonymiser un enregistrement déjà erroné ne réduit pas le risque réglementaire.
- Des données validées permettent un enrichissement des données fiable. Il n’est possible d’adjoindre des attributs tiers à un enregistrement en toute confiance que si ses identifiants essentiels — e-mail, numéro de téléphone ou identifiant client — ont déjà satisfait aux règles de validation. Enrichir un enregistrement associé à une adresse e-mail incorrecte risque de rattacher les attributs ajoutés à la mauvaise personne, voire à personne du tout.
- Des données non validées faussent les modèles prédictifs. Un modèle de prédiction du désabonnement entraîné sur des enregistrements aux formats de date incohérents interprète mal l’ancienneté des clients, générant des prédictions qui semblent précises mais reposent sur des données parasites.
Récapitulatif :
- Les données erronées détectées tôt coûtent moins cher à corriger.
- Les enregistrements peu fiables gaspillent le budget média et faussent les modèles.
- Les référentiels réglementaires exigent des données dont l’exactitude est vérifiable.
- L’enrichissement et la normalisation ne fonctionnent efficacement que sur une base de données validée.
Quelles sont les principales techniques de validation des données ?
Les techniques de validation des données ne sont pas interchangeables. Chacune cible une catégorie spécifique d’erreurs, et recourir à une technique inadaptée gaspille des ressources informatiques sans résoudre le problème réel. Les descriptions et le tableau ci-dessous associent chaque technique à sa catégorie d’erreurs, à un exemple concret de défaillance et au risque métier qu’elle permet de prévenir.
- Validation de type vérifie qu’un champ contient le type de données attendu. Un champ de revenus recevant la chaîne «N/A» au lieu d’une valeur numérique échoue à la validation de type et doit être signalé avant d’atteindre un modèle financier. Sans ce contrôle, les fonctions d’agrégation génèrent une erreur ou suppriment silencieusement l’enregistrement.
- Validation de plage et de contrainte vérifie qu’une valeur s’inscrit dans une limite acceptable. Un champ d’âge client acceptant 847 comme entrée valide révèle l’absence d’une règle de plage. Pour une audience de consommateurs, les âges valides se situent généralement entre 18 et 120 ans. Les valeurs hors plage faussent les moyennes et altèrent les définitions de segments.
- Validation de format applique des modèles structurels à l’aide d’expressions régulières ou de règles de schéma. Un champ de numéro de téléphone américain doit correspondre à un format à 10 chiffres. Un enregistrement contenant «555-CALL-NOW» échoue à la validation de format et ne peut pas être exploité de manière fiable pour les campagnes SMS.
- Validation de cohérence (entre champs) vérifie que les champs associés sont cohérents entre eux. Un enregistrement où «country» est défini sur «US» mais où «postal_code» contient une chaîne alphanumérique à six caractères au format canadien échoue à la validation de cohérence. L’un des deux champs est erroné, et sans ce contrôle, l’enregistrement risque d’être acheminé vers la mauvaise équipe régionale.
- Validation d’unicité vérifie que les enregistrements censés être distincts ne sont pas dupliqués. Deux enregistrements clients partageant la même adresse e-mail mais associés à des niveaux de fidélité différents altèrent toute logique de personnalisation en aval reposant sur l’e-mail.
- Validation de complétude confirme que les champs obligatoires sont renseignés. Un enregistrement de lead B2B dont le champ «company_name» est absent ne peut pas être acheminé vers la bonne équipe de compte. La validation de complétude détecte ce problème dès l’ingestion, avant le transfert des données.
- Validation de l’intégrité référentielle garantit qu’une clé étrangère dans un jeu de données pointe vers un enregistrement qui existe bien dans le jeu de données référencé. Un enregistrement de commande référençant un customer_id absent de la table maître des clients rend cette commande orpheline dans toute jointure, la rendant ainsi invisible dans les rapports de revenus.
Validation des données : déroulement étape par étape
Un processus de validation des données est une séquence répétable appliquée de façon systématique, et non une vérification manuelle ponctuelle. Les organisations qui traitent la validation comme une activité au cas par cas passent plus de temps à éteindre des incendies en aval qu’à construire des pipelines fiables.
- Étape 1 : Définition des règles de validation. Avant d’écrire la moindre ligne de code, définissez par écrit ce que signifie « valide » pour chaque champ. Les règles doivent être approuvées conjointement par le producteur de données (le système ou l’équipe qui envoie les données) et le consommateur de données (le système ou l’équipe qui les reçoit). Les règles non documentées sont la principale cause de dérive des règles : la définition de « valide » évolue progressivement sans que personne ne s’en aperçoive, jusqu’à ce qu’une défaillance se propage en cascade.
- Étape 2 : Profilage des données entrantes. Avant d’appliquer les règles, effectuez une synthèse statistique du jeu de données. Le profilage révèle la distribution réelle des valeurs, le pourcentage de valeurs nulles par champ et les plages de valeurs inattendues. Cette étape permet de déterminer quelles règles sont nécessaires et si les règles existantes sont correctement calibrées. Par exemple, si le profilage indique que 40 % des enregistrements dans un champ « phone » contiennent des formats internationaux, une règle n’acceptant que les formats américains à 10 chiffres rejette des données pourtant valides.
- Étape 3 : Application programmée des règles de validation. Exécutez les règles définies sur chaque enregistrement. Les moteurs de règles automatisés détectent les erreurs à la vitesse d’ingestion des données. Les vérifications manuelles par sondage ne détectent qu’une fraction des erreurs et introduisent une variabilité humaine. Un contrôle par sondage portant sur 5 % des enregistrements passe à côté des erreurs systématiques affectant les 95 % restants.
- Étape 4 : Classer et acheminer les échecs. Les erreurs de validation ne nécessitent pas toutes la même réponse. Les enregistrements dont certains champs non critiques sont manquants peuvent être mis en quarantaine pour enrichissement. Ceux dont les identifiants sont invalides peuvent être rejetés purement et simplement. La classification évite à la fois le rejet excessif (élimination de données récupérables) et le rejet insuffisant (transmission de données erronées vers les systèmes en exploitation).
- Étape 5 : Journaliser, alerter et générer des rapports. Les résultats de validation doivent être consignés. Le suivi des taux d’échec dans le temps peut révéler des problèmes systémiques en amont. Un pic d’erreurs de format à une date précise indique une modification du système source qui nécessite une investigation. Sans journaux, les mêmes erreurs peuvent se reproduire sans que personne n’en identifie la cause profonde.
- Étape 6 : Renvoyer les résultats vers la source. La validation est la plus efficace lorsque les erreurs sont signalées à l’équipe ou au système qui a produit les données. Un feedback en boucle fermée favorise l’amélioration en amont et réduit les erreurs récurrentes. C’est l’étape que la plupart des organisations omettent — et cette omission transforme la validation en centre de coût permanent, plutôt qu’en véritable levier d’amélioration de la qualité des données.
La normalisation et le nettoyage des données suivent généralement ce processus. Une fois les enregistrements validés et classifiés, la normalisation uniformise les formats (par exemple, en convertissant tous les champs de date au format ISO 8601), tandis que le nettoyage corrige ou supprime les enregistrements invalides avant leur acheminement vers les systèmes de stockage ou d’activation.
Récapitulatif :
- Définir les règles avant tout traitement des données.
- Commencer par le profilage et calibrer les règles selon les données réelles.
- Automatiser l’application des règles ; les contrôles manuels ne passent pas à l’échelle.
- Classer les erreurs par gravité avant de les acheminer.
- Journaliser l’ensemble des événements et remonter les résultats en amont.
Comment choisir et mettre en œuvre une approche de validation ?
Le choix de la bonne approche de validation repose sur trois conditions propres à l’organisation : le volume de données, le nombre de systèmes sources et la maturité technique de l’équipe en charge du pipeline. Déployer un moteur de règles de niveau entreprise pour un flux à source unique et faible volume relève de la sur-ingénierie. Se limiter à des contrôles manuels ponctuels pour un pipeline multi-sources en temps réel constitue, à l’inverse, une approche nettement sous-dimensionnée.
Cadre décisionnel :
- Si l’organisation ingère des données depuis une source unique à faible volume (moins de 100 000 enregistrements par lot), une validation manuelle ou basée sur des feuilles de calcul, appuyée par des règles documentées, suffit pour démarrer. À ce stade, la priorité porte sur la documentation des règles, et non sur l’outillage.
- Si votre organisation ingère des données depuis plusieurs sources avec des schémas différents, des outils de validation au niveau du schéma — dotés de bibliothèques de règles de format et de cohérence — sont indispensables pour éviter les conflits entre sources. Sans application stricte des schémas, deux sources peuvent définir « customer_id » différemment, et ce conflit ne se manifeste qu’au moment où une jointure échoue.
- Si votre organisation traite des flux d’événements en temps réel (flux de clics, données de transaction), la validation en streaming — qui contrôle les enregistrements au point de collecte — est indispensable. La validation par lots seule permet aux données erronées de pénétrer dans les systèmes en aval avant la fermeture de la prochaine fenêtre de traitement par lots, ce qui peut représenter des heures d’enregistrements corrompus.
- Si votre organisation gère des données clients réglementées (données de santé, financières ou d’identité), la validation doit inclure des contrôles d’exhaustivité et d’intégrité référentielle liés aux exigences de champs dictées par la conformité, ainsi que des journaux d’audit immuables pour chaque résultat de validation.
Liste de contrôle pour l’évaluation d’une solution de validation :
- Prend-elle en charge les sept techniques de validation (type, plage de valeurs, format, cohérence, unicité, exhaustivité, intégrité référentielle) ?
- Valide-t-elle les données au niveau du schéma avant leur chargement en stockage ?
- Génère-t-elle des journaux d’échecs lisibles par les machines ?
- S’intègre-t-elle aux workflows existants de l’équipe pour la modélisation des données et la transformation des données ?
- Passe-t-elle à l’échelle pour absorber les volumes d’ingestion maximaux de l’organisation sans introduire de latence ?
Adobe Experience Platform applique la validation au niveau de la couche de schéma en s’appuyant sur le standard Modèle de données d’expérience, qui impose des règles de type de champ, de format et d’exhaustivité au moment de l’ingestion, avant que les données n’intègrent le profil unifié. Pour les entreprises qui gèrent des données clients sur plusieurs canaux et systèmes sources, cette validation intégrée réduit la charge de rédaction manuelle des règles et fournit un ensemble de règles standardisé, aligné sur les structures de données clients courantes. Les décisions de modélisation des données prises en amont dans le schéma du Modèle de données d’expérience déterminent directement les règles de validation applicables, rendant la conception de schéma et la validation indissociables à l’échelle de l’entreprise.
Pour les équipes qui n’ont pas encore atteint l’échelle d’une grande entreprise, le cadre décisionnel présenté ci-dessus reste applicable : commencez par documenter les règles, profilez les données avant de déployer les contrôles et progressez vers l’automatisation à mesure que les volumes et la complexité des sources augmentent. Les bonnes pratiques en matière d’hygiène des données — notamment la documentation cohérente des règles, le feedback en boucle fermée aux équipes sources et les audits réguliers des règles — constituent le socle, quel que soit l’outillage utilisé.
À retenir : Choisissez l’approche de validation en fonction du volume de données, du nombre de sources et des exigences de conformité. Sélectionnez ensuite les outils adaptés, et non l’inverse.
Foire aux questions (FAQ)
Quelle est la différence entre la validation et la vérification des données ?
Que se passe-t-il si vous ignorez la validation des données ?
Quel est le lien entre la validation des données et la gestion de la qualité des données ?
Quels sont les principaux défis des processus de validation des données ?
Qui est responsable de la validation des données au sein d’une organisation ?
Construisez des pipelines de données plus fiables
La validation des données est le premier rempart contre les erreurs qui se propagent silencieusement et conduisent à de mauvaises décisions, des campagnes ratées et des lacunes de conformité. Découvrez comment Adobe Experience Platform assure la validation des données d’entreprise et la gestion de la qualité des données sur l’ensemble des canaux et systèmes sources sur Adobe Experience Platform.
Recommandations de lecture
https://business.adobe.com/fragments/resources/cards/thank-you-collections/rtcdp