不正なデータは声を上げません。静かにレポートを歪め、後続のパイプラインを壊し、その後のあらゆる意思決定への信頼を少しずつ損なっていきます。データ検証は、こうした問題が複合的に広がる前に検出する体系的なチェックです。
主な内容:
データ検証とは何か
データ検証とは、データがシステムに投入されたり意思決定に活用されたりする前に、事前定義されたルールを満たしているかを確認するプロセスです。ルールの対象は、フォーマット、完全性、範囲、一貫性など多岐にわたります。日付フィールドが 「13/32/2024」 というデータを何の警告もなく受け入れてしまえば、それは検証の失敗であり、そのフィールドの後続レコードすべてに不備が生じることになります。
データに関わるすべてのチームが、名称はともかく、検証という課題に直面しています。CRMエクスポートをインポートするマーケティングアナリスト、APIレスポンスをデータウェアハウスに読み込むエンジニア、サードパーティのオーディエンスフィードを確認するデータスチュワード、それぞれがエラーを源流で検出するために検証チェックに依存しています。こうした受け渡しに共通するのはリスクです。送信側システムにおける 「valid」 の定義が、受信側システムの要件と一致しているとは限りません。
検証が特に重要となる瞬間は3つあります。1つ目は、データが初めてシステムに取り込まれるとき。2つ目は、データ変換の過程でシステム間を移動するとき。このフェーズでは、フォーマットの不一致やエンコードの違いが起きやすくなります。3つ目は、レポーティングのために集約されるとき。欠損値やフィールド定義の不一致が、合計値や平均値を密かに歪める可能性があります。各受け渡しポイントは、チェックが存在しなければエラーが伝播しうる箇所です。
データ検証とデータクレンジングの違いも押さえておく必要があります。検証はデータがルールに違反しているかどうかを特定し、クレンジングは問題のあるレコードを修正または削除します。検証は 「このデータは使用可能か?」 という問いに答え、クレンジングは 「どのように修正するか?」 という問いに答えます。どちらもより広いデータ品質管理ワークフローの一部ですが、目的と実施タイミングは異なります。
重要なポイント:検証はチェックポイントです。データを修正する機能ではなく、データが次のステップに進む適性を判断するものです。
データ検証がビジネスの意思決定に不可欠な理由
意思決定の精度は、その根拠となるデータの品質に直結します。例えば、メールアドレスの15%が無効なレコードを基に顧客セグメンテーションモデルを構築した場合、生成されたセグメントには到達不能な連絡先が含まれ、メッセージが届かずコンバージョンにもつながらない相手にキャンペーン予算を浪費することになります。モデル自体は統計的に問題なく見えても、実際の運用では何の役にも立ちません。
- 検証で手戻りコストを削減。取り込み時のエラーは修正コストを低く抑えることができます。バッチ処理中に無効な郵便番号が検出された場合、隔離にかかる時間はわずか数秒です。同じエラーでも、経営層へのレポート配布後に発覚すると、再分析・再周知・信頼回復が必要となります。後工程でのエラー発見に伴う時間と信頼性のコストは、事前チェックのコストを大幅に上回ります。
- 法令遵守にはデータ検証が不可欠。EU 一般データ保護規則(GDPR)やカリフォルニア州消費者プライバシー法(CCPA)などのプライバシー規制では、個人データの正確性と最新性が求められます。同意フラグが古かったり識別子が誤っていたりする未検証レコードは、コンプライアンス上のリスクを招き、監査で問題が表面化します。個人情報保護のためにデータ匿名化技術を適用している組織においても、検証済みのソースレコードが必要です。誤りを含むレコードを匿名化しても、規制上のリスクは軽減されません。
- 検証済みデータで信頼性の高いデータエンリッチメントを実現。メール、電話番号、顧客IDなどのコア識別子が検証ルールを通過して初めて、サードパーティの属性をレコードに確実に付加することができます。無効なメールアドレスを持つレコードをエンリッチメントすると、付加した属性が誤った相手に紐付けられるか、誰にも紐付けられない可能性があります。
- バリデーション未実施のデータは予測モデルを歪める。日付フォーマットが一致しないレコードで学習した解約予測モデルは、お客様の継続利用期間を誤って解釈し、精度が高く見えても実際にはノイズに基づいた予測を生成します。
まとめ:
- 不良データは早期に発見するほど修正コストを抑えることができます。
- 信頼性の低いレコードは広告費を無駄にし、モデルの精度を歪めます。
- コンプライアンス規制では、正確性を証明できるデータが求められます。
- エンリッチメントと標準化は、検証済みのデータ基盤があって初めて機能します。
データ検証の主要な手法とは?
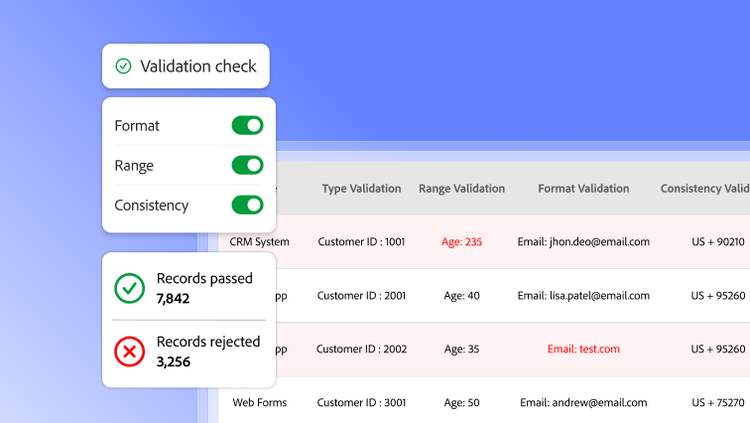
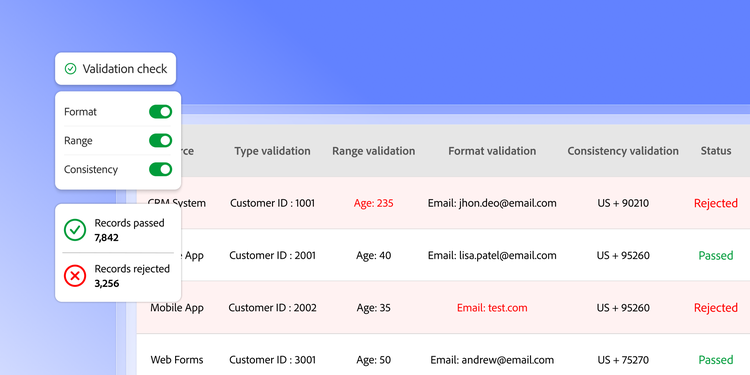
検証手法に互換性はありません。各手法は特定の種類のエラーを対象としており、誤った手法を適用するとコンピューティングリソースが無駄になり、本来の問題を見落とすことになります。以下の説明と表では、各手法をエラーの種類、具体的な失敗事例、防止できるビジネスリスクと対応付けています。
- 型検証は、フィールドに期待されるデータ型が格納されているかどうかを確認します。数値の代わりに文字列 「N/A」 を受け取った売上フィールドは型検証に失敗するため、財務モデルに渡される前にフラグを立てる必要があります。このチェックがなければ、集計関数はエラーを生成するか、エラーを出さずにレコードを破棄します。
- 範囲・制約検証は、値が許容範囲内に収まっているかどうかを確認します。847を有効な入力値として受け入れるお客様の年齢フィールドは、範囲ルールが欠如していることを示します。消費者向けオーディエンスの有効な年齢は通常18歳から120歳の範囲です。範囲外の値は平均値を歪め、セグメント定義を破損させます。
- フォーマット検証は、正規表現またはスキーマルールを使用して構造パターンへの準拠を確認します。米国の電話番号フィールドは10桁のパターンに一致している必要があります。「555-CALL-NOW」というレコードはフォーマット検証に失敗するため、SMS送信に確実に使用することができません。
- 整合性検証(クロスフィールド)は、関連フィールド間のデータが一致していることを確認します。「country」が 「US」 であるにもかかわらず、「postal_code」にカナダ形式の6文字の英数字文字列が含まれているレコードは整合性検証に失敗します。2つのフィールドのいずれかに誤りがあり、このチェックがなければ、レコードが誤った地域チームに振り分けられる可能性があります。
- 一意性検証は、個別であるべきレコードが重複していないことを確認します。同じメールアドレスを共有しながら異なるロイヤルティ階層のラベルを持つ2件のお客様レコードは、メールアドレスをキーとする後続のパーソナライズ機能ロジックを破損させます。
- 完全性検証は、必須フィールドに値が格納されていることを確認します。「company_name」が欠落しているB2Bリードレコードは、適切なアカウントチームに振り分けることができません。完全性検証は、引き継ぎ時ではなくデータ取り込み時にこの問題を検出します。
- 参照整合性検証は、あるデータセット内の外部キーが参照先のデータセットに実際に存在するレコードを指し示していることを確認します。顧客マスターテーブルに存在しないcustomer_idを参照している注文レコードは、結合処理で孤立し、売上レポートから参照できなくなります。
データ検証プロセスはステップごとにどう機能するのか
データ検証プロセスとは、一度限りの手動チェックではなく、一貫して繰り返し適用される体系的な手順です。検証をその場しのぎの作業として捉えている組織は、信頼性の高いパイプラインの構築よりも、下流で発生するエラーの対処に多くの時間を費やすことになります。
- ステップ1:検証ルールを定義する。コードを記述する前に、各フィールドにおける 「有効」 の意味を明確に定義してください。ルールは、データプロデューサー (データを送信するシステムまたはチーム) とデータコンシューマー (データを受信するシステムまたはチーム) の両者間で合意しておく必要があります。ドキュメント化されていないルールはルールドリフトの主な原因です。ルールドリフトとは、障害が連鎖して初めて気づくまでの間に、「有効」の定義がいつの間にか変化してしまう現象を指します。
- ステップ2:受信データをプロファイリングする。ルールを適用する前に、データセットの統計サマリーを実行してください。プロファイリングにより、値の実際の分布、フィールドごとのnull値の割合、予期しない値の範囲が明らかになります。このステップによって、どのルールが必要か、また既存のルールが適切に設定されているかどうかを判断できます。たとえば、「phone」フィールドのレコードの40%が国際電話番号形式であることがプロファイリングで判明した場合、米国の10桁パターンのみを想定したルールは有効なデータを弾いてしまいます。
- ステップ3:検証ルールをプログラムで適用する 定義したルールをすべてのレコードに適用します。自動化されたルールエンジンは、データ取り込みの速度でエラーを検出できます。手動による抜き取り検査で捕捉できるのはごく一部のエラーに限られ、人的なばらつきも生じます。レコードの5%を対象とした抜き取り検査では、残り95%に影響する体系的なエラーを見逃すことになります。
- ステップ4:エラーを分類してルーティングする 検証で失敗したすべてのレコードに、同じ対処が必要なわけではありません。重要度の低いフィールドが欠損しているレコードは、エンリッチメントのために隔離される場合があります。無効な識別子を持つレコードは即座に却下される場合があります。適切な分類により、過剰却下 (復元可能なデータの破棄) と過少却下 (不正なデータの本番システムへの流入) の両方を防ぐことができます。
- ステップ5:ログ記録、アラート、レポーティング 検証結果は必ず記録する必要があります。経時的に追跡したエラー発生率から、上流側の体系的な問題を明らかにすることができます。特定の日付にフォーマットエラーが急増している場合は、調査が必要なソースシステムの変更を示しています。ログがなければ、同じエラーが繰り返し発生しても、誰も根本原因を特定できません。
- ステップ6:検証結果をソースにフィードバックする 失敗したレコードをデータを生成したチームやシステムに報告することで、検証の効果は最大化されます。フィードバックループを確立することで、上流側の改善が促進され、繰り返しエラーを削減できます。多くの組織がこのステップを省略しがちですが、省略すると、検証はデータ品質向上の推進力ではなく、恒久的なコストセンターになってしまいます。
データの標準化とデータクレンジングは、通常このプロセスの後に行われます。レコードが検証・分類されると、標準化によってフォーマットが正規化され (例:すべての日付フィールドをISO 8601形式に変換)、クレンジングによって無効なレコードが修正または削除されてから、ストレージやアクティベーションに進みます。
まとめ:
- データに触れる前にルールを定義する。
- まずプロファイリングを実施し、ルールを実態に合わせて調整する。
- ルール適用は自動化する。手動チェックでは規模に対応できない。
- ルーティングの前に、重大度に基づいてエラーを分類する。
- すべてをログに記録し、結果を上流にフィードバックする。
組織はどのように検証アプローチを選択・実装すべきか
適切な検証アプローチは、データ量、ソースシステムの数、パイプラインを管理するチームの技術的成熟度という3つの組織的条件によって決まります。単一ソースで低ボリュームのデータフィードにエンタープライズグレードのルールエンジンを適用するのは過剰設計です。複数ソースのリアルタイムパイプラインに手動の抜き取り検査を適用するのは設計不足です。
意思決定フレームワーク:
- 単一のソースから低ボリューム (バッチあたり100,000件未満) でデータを取り込む場合は、ルールを文書化した上での手動またはスプレッドシートベースの検証で十分です。この段階での優先事項はツールの選定ではなく、ルールの文書化です。
- 異なるスキーマを持つ複数のソースからデータを取り込む場合は、クロスソース間の競合を防ぐために、フォーマットおよび一貫性ルールのライブラリを備えたスキーマレベルのデータ検証ツールが必要です。スキーマを強制しなければ、2つのソースが 「customer_id」 を異なる方法で定義する可能性があり、その競合はジョインが失敗するまで検出されません。
- リアルタイムのイベントストリーム (クリックストリーム、トランザクションデータ) を運用する場合は、収集時点でレコードを検証するストリーミング検証が必要です。バッチ検証だけでは、次のバッチウィンドウが閉じるまでの間に不正なデータが下流のシステムへ流入してしまい、数時間分のレコードが破損するリスクがあります。
- 規制対象のお客様データ (健康情報、金融情報、または個人識別情報) を管理する場合は、コンプライアンスで定義されたフィールド要件に紐づいた完全性チェックと参照整合性チェックを検証に組み込み、すべての検証結果の変更不可能な監査ログも備える必要があります。
検証ソリューションの評価チェックリスト:
- 7つすべての検証手法 (型、範囲、フォーマット、一貫性、一意性、完全性、参照整合性) をサポートしていますか?
- データがストレージに格納される前に、スキーマレベルで検証を行うことができますか?
- 機械可読な障害ログを生成できますか?
- チームの既存のデータモデリングおよびデータ変換ワークフローと統合できますか?
- 組織のピーク時のデータ取り込み量に対して、遅延なくスケールできますか?
Adobe Experience Platformは、エクスペリエンスデータモデル標準を使用してスキーマレイヤーで検証を適用し、データが統合プロファイルに入る前に、取り込み時にフィールドタイプ、フォーマット、完全性ルールを強制します。複数のチャネルおよびソースシステムにわたってお客様データを管理するエンタープライズ向けに、この組み込み検証は手動ルール記述の負担を軽減し、一般的なお客様データ構造に合わせた標準化されたルールセットを提供します。エクスペリエンスデータモデルスキーマの上流で行われるデータモデリングの決定は、適用される検証ルールを直接決定するため、エンタープライズ規模ではスキーマ設計と検証を切り離すことができません。
エンタープライズ規模に達していないチームにも、上記の意思決定フレームワークは有効です。まずルールを文書化し、チェックを導入する前にデータをプロファイリングして、データ量やソースの複雑さが増すにつれて自動化へと移行していきましょう。ルールの一貫したドキュメンテーション、ソースチームへのクローズドループのフィードバック、定期的なルール監査といったデータ整備のベストプラクティスは、使用するツールに関わらず、常に基盤となります。
重要なポイント:データ量、ソース数、コンプライアンス要件に基づいて検証アプローチを選択し、それに合ったツールを選びましょう。ツールありきで考えるのは逆効果です。
よくある質問
データ検証とデータ照合の違いとは?
データ検証を省略するとどうなるか?
データ検証とデータ品質管理の関係とは?
データ検証プロセスにおける主な課題とは?
組織内でデータ検証を担うのは誰か?
信頼性の高いデータパイプラインの構築を始めましょう
データバリデーションは、気づかぬうちに誤りが積み重なり、誤った意思決定や失敗したキャンペーン、コンプライアンス上の抜け穴へとつながるリスクを防ぐための最前線です。Adobe Experience Platformがエンタープライズのデータバリデーションとデータ品質管理をあらゆるチャネルおよびソースシステム全体でどのようにサポートするかは、Adobe Experience Platformでご確認ください。