Was ist Datentransformation? Prozess, Arten und Tools | Adobe Deutschland
View this page in English (US).Continue

Was ist Datentransformation? Prozess, Arten und Tools

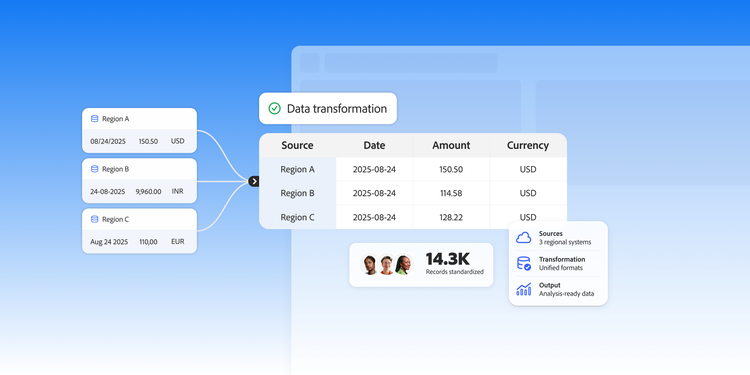
Workflow zur Datentransformation, der Formate, Währungen und Datumsangaben aus mehreren Datenquellen vereinheitlicht.

Hinter jedem Business-Intelligence-Desaster steckt dasselbe Muster: Dashboards, die ordentlich aussehen, aber auf Daten basieren, die nie richtig aufbereitet wurden. Datentransformation verhindert genau das – und wer versteht, wie sie funktioniert, legt den Grundstein für Analysen, denen ihr wirklich vertrauen könnt.

In diesem Artikel geht es um Folgendes:

Was ist Datentransformation?

Datentransformation bezeichnet den Prozess, bei dem Rohdaten aus ihrem ursprünglichen Format oder ihrer Struktur in ein einheitliches, konsistentes Format überführt werden – bereit für die Analyse oder die Weiterverarbeitung in nachgelagerten Systemen. Ein konkretes Beispiel: Ein Einzelhandelsunternehmen zieht Verkaufsdaten aus drei regionalen Datenbanken, die jeweils unterschiedliche Datumsformate und Währungscodes verwenden. Damit ein Reporting-Tool die Ergebnisse regionsübergreifend vergleichen kann, müssen die Daten in ein einheitliches Schema überführt werden – mit standardisierten Datumsangaben, einer gemeinsamen Währung und einheitlichen Feldbezeichnungen.

Innerhalb einer umfassenderen Datenpipeline steht die Transformation zwischen der Ingestion (Daten einlesen) und dem Laden (Daten in ein Warehouse oder eine Analyseplattform übertragen). Verschiedene Rollen sind dabei zu unterschiedlichen Zeitpunkten involviert: Data-Engineers legen die Regeln fest. Business-Analytikerinnen und -Analytiker validieren die Ergebnisse. Marketing-Operations-Teams nutzen die aufbereiteten Daten in Dashboards, Segmentierungstools und Aktivierungsplattformen.

Transformation wird unverzichtbar, sobald eine Organisation mehr als eine Datenquelle nutzt. Ein einzelnes CRM-System benötigt selten eine Transformation. Doch sobald dieses CRM mit einer Anzeigenplattform, einem Support-Ticketing-Tool und einem Web-Analyse-System verbunden wird, wird jeder Feldname, jeder Datentyp und jedes Datensatzformat zur potenziellen Konfliktquelle. Transformation löst diese Konflikte systematisch – nicht durch punktuelle Korrekturen, sondern durch wiederholbare, regelbasierte Logik, die jedes Mal greift, wenn Daten zwischen Systemen übertragen werden.

Dieser Unterschied ist entscheidend: Datentransformation ist keine einmalige Bereinigungsaufgabe, sondern eine kontinuierliche Pipeline-Disziplin. Quellsysteme verändern sich, neue Felder kommen hinzu, und Formate weichen ab. Unternehmen, die Transformation als Projekt statt als laufenden Prozess betrachten, stellen fest, dass ihre Datenqualität innerhalb weniger Monate abnimmt.

Was sind die wichtigsten Arten der Datentransformation?

Datentransformationen lassen sich in mehrere klar abgegrenzte Kategorien einteilen, die jeweils eine bestimmte Art von Datenqualitätsproblem adressieren. Wer die einzelnen Typen kennt, kann Pipelines so gestalten, dass alle Fehlerquellen abgedeckt werden – nicht nur die offensichtlichen.

  • Normalisierung strukturiert Werte in ein einheitliches Format um. Werden beispielsweise alle Telefonnummern in das E.164-Format (+1XXXXXXXXXX) konvertiert, stimmen sie sowohl im CRM als auch auf der Messaging-Plattform überein. Ohne Normalisierung können Datensätze mit derselben Telefonnummer – einmal als „(555) 867-5309“ und einmal als „15558675309“ gespeichert – als zwei verschiedene Personen erscheinen.
  • Aggregation fasst granulare Datensätze zu Produktmetriken zusammen. Ein Finanz-Dashboard, das tägliche Umsatzsummen benötigt, sollte zur Abfragezeit keine Millionen einzelner Transaktionszeilen verarbeiten müssen. Werden die Umsätze pro Transaktion bereits bei der Transformation zu Tagessummen zusammengefasst, wird die nachgelagerte Berichterstellung schneller und kostengünstiger.
  • Filterung entfernt Datensätze, die Qualitäts- oder Relevanzkriterien nicht erfüllen. Ein gängiges Beispiel: Testkonten werden vor der Berechnung der Abwanderungsrate aus der Kundenzahl ausgeschlossen. Werden Testkonten bei der Transformation nicht herausgefiltert, sind alle nachgelagerten Metriken, die auf der Kundenzahl basieren, verfälscht.
  • Mapping und Feldumbenennung gleichen inkonsistente Feldnamen aus verschiedenen Quellen an. Ein System speichert „cust_id“, ein anderes „customer_identifier“. Die Transformation ordnet beide einem einheitlichen Feld „customer_id“ zu, sodass Joins und Lookups im Data Warehouse korrekt funktionieren.
  • Anreicherung ergänzt Datensätze um zusätzliche Attribute aus einer sekundären Quelle. Ein typisches Beispiel ist das Hinzufügen firmografischer Daten – wie Unternehmensgröße und Branche – zu einem Kontaktdatensatz mithilfe eines Drittanbieters. Weitere Informationen zu Implementierungsmustern finden sich in unserem Beitrag zur Datenanreicherung.
  • Anonymisierung und Maskieren ersetzen personenbezogene Werte durch Tokens oder synthetische Entsprechungen. E-Mail-Adressen vor der Weitergabe an einen Analyse-Anbieter durch Hash-Kennungen zu ersetzen ist eine Standardanwendung. Details zur Implementierung finden sich im Beitrag zu Datenanonymisierungstechniken.
  • Typkonvertierung wandelt den Datentyp eines Feldes um. Wird ein Datum im Stringformat („2024-01-15“) in einen echten Datumstyp konvertiert, kann ein BI-Tool Einträge nach Kalenderperioden sortieren und filtern. Ohne Typkonvertierung können Datumsvergleiche fehlschlagen oder falsche Sortierreihenfolgen liefern.

In der Praxis wenden die meisten Pipelines mehrere Transformationstypen nacheinander an. Eine Marketing-Datenpipeline kann beispielsweise Bot-Traffic herausfiltern, Feldnamen zuordnen, Datumsformate normalisieren und Daten zu täglichen Sitzungszählungen aggregieren – und das alles, bevor die Daten die Reporting-Ebene erreichen.

Wie funktioniert der Datentransformationsprozess?

Der Datentransformationsprozess folgt einer klar strukturierten Abfolge von Schritten. Wird ein Schritt übersprungen, entstehen nachgelagerte Fehler, die oft erst dann sichtbar werden, wenn Unternehmensentscheidungen auf Basis fehlerhafter Daten getroffen werden. Konkrete Beispiele für jeden einzelnen Schritt in der Praxis finden sich in unserer Übersicht zu Datentransformationsbeispielen.

Schritt 1: Quelldaten analysieren. Bevor Transformationsregeln erstellt werden, prüfen Analytikerinnen und Analytiker die eingehenden Daten auf Nullwerte, Duplikate, Typinkonsistenzen und Ausreißer. Eine Profilierungsanalyse eines CRM-Exports kann beispielsweise ergeben, dass bei 12 % der Datensätze keine E-Mail-Adresse vorhanden ist, dass das Feld „state“ sowohl Abkürzungen als auch vollständige Namen enthält und dass vereinzelte Datensätze Erstellungsdaten aus dem Jahr 1900 aufweisen. Profiling legt den Umfang des Problems offen und zeigt auf, welche Transformationstypen erforderlich sind.

Schritt 2: Transformationsregeln definieren. Ingenieurinnen und Ingenieure sowie Analytikerinnen und Analytiker legen gemeinsam fest, wie „gute“ Daten aussehen. Die Regeln werden dokumentiert, damit sie bei jeder Pipeline-Ausführung konsistent angewendet werden – und nicht von verschiedenen Teammitgliedern unterschiedlich ausgelegt werden. Eine Regel könnte beispielsweise lauten: "Alle Datumsfelder müssen im ISO-8601-Format (YYYY-MM-DD) in UTC konvertiert werden. Datensätze mit leeren E-Mail-Adressen werden beibehalten, aber mit dem Feld data_quality_warning mit dem Wert ‚missing_email‘ gekennzeichnet." In diesem Schritt werden Datenmodellierungsentscheidungen getroffen, da das Zielschema definiert sein muss, bevor entsprechende Regeln erstellt werden können.

Schritt 3: Transformationen anwenden. Die Regeln werden per Code (SQL, Python), über ein visuelles ETL- oder ELT-Tool oder mithilfe eines deklarativen Transformations-Frameworks ausgeführt. In diesem Schritt werden die Rohdaten in das Zielformat überführt.

Schritt 4: Ausgabe validieren. Transformierte Daten werden auf erwartete Zeilenanzahlen, Wertebereiche und referenzielle Integritätsprüfungen getestet. Sinkt die Zeilenanzahl um mehr als einen definierten Schwellenwert, sollte dies einen Alarm auslösen, bevor die Daten das Warehouse erreichen. Erst durch Datenvalidierung in diesem Schritt lässt sich eine zuverlässige Pipeline von einer unterscheiden, die nachgelagerte Berichte unbemerkt verfälscht.

Der Prozess verläuft in der Praxis selten linear. Validierungsfehler führen zurück zu Schritt 2, wo die Regeln überarbeitet werden. Unternehmen, die die Transformation als einmaliges Projekt statt als kontinuierliche Pipeline-Disziplin betrachten, erleben regelmäßig, wie die Datenqualität mit der Zeit sinkt – wenn sich Quellsysteme ändern und neue Felder ohne entsprechende Transformationsregeln eingeführt werden.

Das Wichtigste in Kürze: Die Qualität der Transformation wird in der Phase der Regeldefinition festgelegt – nicht bei der Ausführung. Wer in Schritt 2 investiert, senkt die Fehlerkosten in Schritt 4.

Was ist der Unterschied zwischen ETL und ELT?

ETL (Extract, Transform, Load) und ELT (Extract, Load, Transform) sind die zwei dominanten Architekturmuster für die Datentransformation in einer Pipeline. Der Unterschied liegt nicht nur in der Reihenfolge der Schritte – er hat direkte Auswirkungen auf Kosten, Latenz und die erforderlichen Kompetenzen im Team.

ETL transformiert Daten, bevor sie das Data Warehouse erreichen – in einer dedizierten Verarbeitungsebene. Dieses Muster eignet sich besonders für Umgebungen, in denen Rohdaten das Warehouse unter keinen Umständen erreichen dürfen: aus Compliance-Gründen, aufgrund der Sensibilität personenbezogener Daten (PII) oder weil das Zielsystem über begrenzte Rechenkapazität verfügt. Ein klassischer Use Case für ETL ist eine Gesundheitseinrichtung, die Patientendaten anonymisieren muss, bevor sie in eine gemeinsam genutzte Analyseumgebung einfließen. Der Nachteil liegt in der Latenz: Daten müssen vollständig transformiert sein, bevor sie abgefragt werden können – was die Zeit bis zur Erkenntnisgewinnung verlängert.

ELT lädt Rohdaten zunächst in das Warehouse und führt die Transformation anschließend direkt dort durch – mithilfe von SQL oder einem deklarativen Transformations-Framework. Dieses Muster eignet sich besonders für Cloud-Data-Warehouses wie Snowflake, BigQuery oder Redshift, wo Rechenleistung elastisch skaliert und die Transformationslogik zusammen mit den Daten versioniert werden kann. Analystinnen und Analysten können in derselben Umgebung sowohl Roh- als auch transformierte Daten abfragen – das beschleunigt Debugging und explorative Analysen. Der Nachteil: Das Warehouse trägt die Speicherkosten für Rohdaten, und Unternehmen mit strengen regulatorischen Anforderungen an die Speicherung von Rohdaten benötigen möglicherweise zusätzliche Zugriffskontrollen.

Die Branche hat sich bei den meisten analytischen Workloads auf ELT ausgerichtet, da die Rechenkosten von Cloud-Warehouses im vergangenen Jahrzehnt deutlich gesunken sind. ETL bleibt die richtige Wahl, wenn die Transformationslogik außerhalb des Warehouse-Bereichs ausgeführt werden muss – etwa wenn Daten vor dem Eingang in eine gemeinsam genutzte Umgebung anonymisiert werden müssen. Viele Unternehmen setzen auf einen hybriden Ansatz: ETL für sensible Datenströme, ELT für alles andere.

Welche Vorteile bietet die Datentransformation für Unternehmen?

Eine konsistente Datenqualität über alle Systeme hinweg beseitigt den Abstimmungsaufwand, der typischerweise einen erheblichen Teil der Arbeitszeit von Analytikerinnen und Analytikern beansprucht. Schätzungen aus der Praxis beziffern diesen Anteil häufig auf 20 bis 40 Prozent der gesamten Analysestunden – allerdings sollten Unternehmen ihre eigene Ausgangslage messen, bevor sie intern eine konkrete Zahl kommunizieren. Diese gewonnene Zeit lässt sich stattdessen für Interpretation und Entscheidungsunterstützung nutzen, anstatt sie mit manueller Datenaufbereitung zu verbringen.

Die Datentransformation ermöglicht es, Daten aus verschiedenen Unternehmensbereichen zusammenzuführen und gemeinsam zu analysieren. Ein Unternehmen, das seine CRM-, Werbeplattform- und Web-Analytics-Daten in ein einheitliches Schema überführt hat, kann die Kosten der Kundenakquise auf der Ebene einzelner Kundinnen und Kunden berechnen. Diese Berechnung ist nicht möglich, wenn jedes System eine andere Kundenkennung und ein anderes Datumsformat verwendet. Die Möglichkeit, diese Datensätze zu verknüpfen, ist ein direktes Ergebnis von Feldzuordnung, Normalisierung und Datenstandardisierung im Rahmen der Transformation.

Regulatorische Compliance profitiert direkt von einer strukturierten Transformation. Werden Anonymisierung und Maskieren als verbindliche Schritte in die Transformationsebene integriert, erhalten alle nachgelagerten Systeme automatisch konforme Daten. Dadurch entfällt das Risiko, dass einzelne Analytikerinnen oder Analytiker beim Ad-hoc-Export versehentlich sensible Felder nicht ausschließen.

Schnelleres und zuverlässigeres Reporting verkürzt die Zeit zwischen dem Eintreten eines Ereignisses und der daraufhin getroffenen Geschäftsentscheidung. Unternehmen, die mit den Daten von gestern statt von letzter Woche arbeiten, erkennen Leistungsprobleme – wie eine sinkende Konversionsrate oder einen Anstieg bei Support-Tickets – bevor diese sich zu echten Umsatzproblemen auswachsen.

Welche Herausforderungen bringt die Datentransformation mit sich?

  • Schema-Drift ist der häufigste Ausfalltyp bei Transformationen im Produktivbetrieb. Ändert ein Quellsystem einen Feldnamen, fügt ein neues Feld hinzu oder passt einen Datentyp an, ohne das Pipeline-Team zu informieren, brechen die Transformationsregeln unbemerkt zusammen. Fehlerhafte oder fehlende Daten gelangen ins Data Warehouse, bevor es jemandem auffällt. Die Folge sind Berichte, die Umsätze unterschätzen oder Abwanderungsraten überschätzen – oft tagelang oder wochenlang, bevor der Fehler entdeckt wird.
  • Datenvolumen-Skalierung ist eine Herausforderung, die sich schleichend bemerkbar macht. Transformationsjobs, die mit einem Monat an Daten problemlos laufen, beginnen bei drei Jahren an Verlaufsdaten zu versagen oder in einen Timeout zu laufen. Unternehmen, die ihre Transformationslogik von Anfang an nicht auf Skalierbarkeit ausgelegt haben, stehen bei wachsendem Datenvolumen vor kostspieligen Pipeline-Überarbeitungen – und das Datenvolumen wächst immer.
  • Die Governance von Transformationsregeln wird häufig als operativer Aufwand unterschätzt. Transformationslogik, die über undokumentierte SQL-Skripte, Tabellenkalkulationsformeln und Tool-spezifische Konfigurationen verteilt ist, lässt sich kaum prüfen, testen oder weitergeben. Teams, die ihre Transformationslogik nicht unter Versionskontrolle stellen, können nicht mehr nachvollziehen, warum sich eine Metrik zwischen Berichtszeiträumen verändert hat.

Datenbereinigung und Datenvalidierung müssen fest in den Transformationsprozess integriert sein – sie dürfen nicht als separate vorgelagerte Schritte behandelt werden. Wird die Validierung übersprungen, wirken fehlerhafte Daten nach der Transformation vertrauenswürdig: korrekte Formatierung, richtige Feldbezeichnungen – aber die eigentlichen Werte sind falsch. Entscheidungen, die auf solchen Daten basieren, tragen ein verborgenes Risiko in sich, das im Nachhinein nur schwer zu erkennen ist.

Wie bewertet ihr Datentransformations-Tools richtig?

Transformations-Tools lassen sich in drei übergeordnete Kategorien einteilen, die jeweils auf unterschiedliche Teamstrukturen und Datenumgebungen zugeschnitten sind.

  • Code-first-Frameworks setzen auf SQL- oder Python-basierte Tools, bei denen die Transformationslogik als Code geschrieben, versioniert und wie Software getestet wird. Sie eignen sich am besten für Teams mit Engineering-Kapazitäten, die eine präzise Steuerung und hohe Nachvollziehbarkeit benötigen. Der Nachteil: Die Kompetenzbasis ist höher – Business-Analysts ohne SQL-Kenntnisse können die Transformationslogik nicht eigenständig verwalten oder anpassen.
  • Visuelle ETL- und ELT-Plattformen bieten Drag-and-Drop-Oberflächen, bei denen Transformationsschritte konfiguriert statt codiert werden. Sie eignen sich am besten für Teams, in denen Business-Analysts die Transformationslogik verantworten und Engineering-Ressourcen begrenzt sind. Die Kehrseite: geringere Flexibilität bei komplexen Transformationen und – je nach Tool – eingeschränkte Unterstützung für Versionskontrolle.
  • Eingebettete Transformation in Datenplattformen bezeichnet Cloud-Data-Warehouses und Kundendatenplattformen, die neben Speicher- und Rechenkapazitäten auch native Transformationsfunktionen bieten. Sie eignen sich besonders für Unternehmen, die die Anzahl separater Tools in ihrem Stack minimieren möchten. Den größten Mehrwert bietet diese Option, wenn Datenmodellierung, Datenstandardisierung und Echtzeit-Aktivierung innerhalb derselben Plattform verfügbar sind – das kann Pipeline-Komplexität und Latenz deutlich reduzieren.

Unabhängig von der Kategorie solltet ihr diese Bewertungskriterien anwenden:

  1. Unterstützt das Tool Versionskontrolle und Tests für Transformationsregeln? Transformationslogik ohne Versionskontrolle ist ein Governance-Risiko.
  2. Verarbeitet das Tool Schemaänderungen zuverlässig, oder führt eine Änderung am Quellschema unbemerkt zu einem Pipeline-Ausfall?
  3. Lässt es sich auf die Datenmengen skalieren, mit denen die Organisation in zwei Jahren arbeiten wird – und nicht nur auf die heutigen?
  4. Erstellt es eine dokumentierte Herkunftskarte, die zeigt, welche Quellfelder welche Ausgabefelder erzeugt haben? Eine solche Datenherkunft ist für regulatorische Audits und die Behebung von Datenqualitätsproblemen erforderlich.
  5. Wie hoch sind die Gesamtbetriebskosten – einschließlich der Rechenkosten bei hohem Datenvolumen und des Entwicklungsaufwands für die Pflege des Tools?

Wie wählt ihr den richtigen Ansatz zur Datentransformation?

Mit dem folgenden Entscheidungsframework findet ihr den Transformationsansatz, der zu euren organisatorischen Gegebenheiten passt.

Hat euer Team ausreichend Engineering-Kapazitäten und übersteigen die Datenmengen mehrere zehn Millionen Zeilen, empfiehlt sich ein Code-First-ELT-Framework innerhalb eines Cloud-Warehouse. Das verschafft euch maximale Kontrolle über die Transformationslogik und ermöglicht den Einsatz von Software-Engineering-Methoden wie automatisierten Tests und Peer-Reviews.

Wird euer Team hauptsächlich von Analytikerinnen und Analytikern geleitet, ist der Engineering-Support begrenzt und die Datenmengen sind moderat, empfiehlt sich eine visuelle ETL-Plattform mit integrierten Konnektoren für eure Quellsysteme. Das senkt die Einstiegshürde und ermöglicht es Analytikerinnen und Analytikern, die Transformationslogik eigenständig weiterzuentwickeln – ohne auf Engineering-Sprints warten zu müssen.

Verwaltet ihr Kundendaten für Personalisierung und kanalübergreifende Echtzeit-Aktivierung, empfiehlt sich eine Kundendatenplattform mit integrierten Transformations-, Datenstandardisierungs- und Identitätsbestimmungsfunktionen. Adobe Experience Platform ist für dieses Szenario auf Enterprise-Ebene ausgelegt: Kundendaten aus Dutzenden von Quellen in inkompatiblen Formaten werden in Echtzeit transformiert und gegen ein gemeinsames Schema standardisiert – und fließen ohne Duplizierung sowohl in Analyse- als auch in Aktivierungs-Use-Cases ein. Es ist eine von mehreren Enterprise-Lösungen, die bei entsprechenden Anforderungen eine Evaluierung verdient – nicht die pauschale Antwort auf jeden Datentransformationsbedarf.

Untersagt euer regulatorisches Umfeld, dass personenbezogene Rohdaten in gemeinsam genutzte Umgebungen gelangen, empfiehlt sich eine ETL-Architektur, bei der Anonymisierung und Maskieren vor dem Laden der Daten erfolgen.

Dokumentiert eure Transformationsanforderungen entlang von drei Dimensionen, bevor ihr ein Tool auswählt. Erstens: Anzahl der Quellsysteme und deren Änderungshäufigkeit – sie bestimmen, wie viel Schema-Drift-Resilienz ihr benötigt. Zweitens: Anzahl der nachgelagerten Datenkonsumenten – sie bestimmt, wie viel Governance- und Herkunftsdokumentation erforderlich ist. Drittens: Latenzanforderungen – sie entscheiden, ob eine Batch-Transformation ausreicht oder ob eine nahezu echtzeitfähige Transformation notwendig ist.

Unabhängig vom gewählten Ansatz solltet ihr Best Practices zur Datenhygiene vom ersten Pipeline-Durchlauf an priorisieren. Datenqualitätskontrollen nachträglich in eine bestehende Transformationsebene einzubauen, ist deutlich kostspieliger, als sie von Anfang an zu integrieren.

Häufig gestellte Fragen.

Eine zuverlässige Datentransformationsstrategie zu entwickeln gehört zu den wirkungsvollsten Investitionen, die ein Datenteam tätigen kann. Wenn ihr als Unternehmen bereit seid, Kundendaten kanalübergreifend durch integrierte Transformation, Identitätsbestimmung und Echtzeit-Aktivierung zu vereinheitlichen, erfahrt mehr über Adobe Experience Platform.

Empfehlungen für euch.

Finden wir gemeinsam heraus, wie Adobe eurem Unternehmen helfen kann.

Jetzt loslegen