IA d’entreprise : le problème de contenu
Les entreprises investissent massivement dans l’IA générative, les copilots, la recherche intelligente et les expériences d’assistance automatisée. Pourtant, beaucoup tentent encore d’alimenter ces systèmes avec des PDF fragmentés, des connaissances dupliquées et obsolètes, des référentiels cloisonnés, des métadonnées incohérentes et des workflows de publication conçus pour une autre époque.
Voilà un problème que de nombreux projets d’IA sous-estiment dès le départ. La fiabilité d’un système d’IA ne dépasse jamais celle du contenu qu’il exploite.
Forbes a récemment qualifié la gestion des connaissances de « parent pauvre de la tech » — et avancé qu’elle pourrait bien être le salut de l’IA. Cette formulation résume parfaitement l’urgence de la situation.
La plupart des discussions sur l’IA d’entreprise tournent encore autour des modèles, des copilots et des architectures RAG (génération augmentée par récupération). Pourtant, le véritable défi opérationnel se situe bien en amont. L’IA d’entreprise repose sur un contenu gouverné, structuré et réutilisable, fiable à travers les systèmes, les équipes et les canaux de diffusion.
L’enjeu devient de plus en plus pressant à mesure que la documentation produit évolue : d’un simple support après-vente, elle se transforme en couche opérationnelle centrale alimentant le libre-service client, l’intégration, l’automatisation du support, la récupération de connaissances, les workflows de conformité et les expériences digitales personnalisées.
La pression opérationnelle est déjà perceptible dans l’ensemble des entreprises. Une étude commandée par Adobe et réalisée par S&P Global révèle que 87 % des personnes interrogées peinent à gérer leur contenu tout au long de son cycle de vie, et que 68 % sont confrontées à un trop grand nombre d’applications et de systèmes déconnectés. Ces inefficacités opérationnelles créent précisément le type d’environnements fragmentés qui fragilisent la qualité de récupération de l’IA et la gouvernance en entreprise.
Les entreprises qui continuent de traiter la documentation technique comme une simple sortie de publication statique risquent de voir leurs initiatives IA hériter des mêmes lacunes déjà présentes dans leurs opérations de contenu : informations dupliquées, connaissances obsolètes, terminologie incohérente, faible découvrabilité et gouvernance documentaire fragmentée.
Les entreprises qui réussissent avec l’IA d’entreprise abordent la documentation autrement. Elles créent des écosystèmes de contenu prêts pour l’IA, conçus non seulement pour les lecteurs et lectrices, mais aussi pour les systèmes de récupération, la recherche sémantique, les pipelines d’automatisation et les expériences pilotées par l’IA.
Difficultés des systèmes d’IA face à la documentation d’entreprise
Les grands modèles de langage (LLM) offrent des performances remarquables lorsqu’ils s’appuient sur des connaissances d’entreprise fiables. Le problème vient du fait que de nombreux environnements de documentation d’entreprise n’ont jamais été conçus pour les architectures de récupération modernes.
Les systèmes de documentation traditionnels contiennent souvent des PDF redondants, des procédures dupliquées dans des documents Word, des conventions de nommage et des structures de dossiers incohérentes, du contenu obsolète, des copies non contrôlées distribuées comme versions finales, des référentiels déconnectés et des modèles de responsabilité fragmentés. Les humains peuvent parfois naviguer dans ces incohérences grâce à leur expérience et à leur sens du contexte. Les systèmes d’IA, en revanche, en sont incapables.
De plus en plus d’entreprises se tournent vers la rédaction structurée basée sur DITA et les systèmes de gestion de contenu à composants (CCMS) pour combler ces lacunes fondamentales, car la qualité de la récupération tient d’abord à la façon dont le contenu est créé et gouverné, et non à la seule façon dont il est récupéré.
À mesure que les entreprises déploient des systèmes d’assistance pilotés par l’IA et des copilotes d’entreprise, ces faiblesses s’amplifient. Les systèmes de récupération peinent à identifier les informations faisant autorité. Les réponses générées par l’IA peuvent fusionner des consignes obsolètes et actuelles. Des sujets similaires assortis d’une terminologie incohérente engendrent de l’ambiguïté. Les documents longs contiennent souvent des informations mal segmentées qui nuisent à la précision de la récupération.
Le résultat va bien au-delà d’une simple perte d’efficacité : c’est la confiance dans les réponses elles-mêmes qui en pâtit.
Ce défi explique pourquoi de nombreuses initiatives d’IA d’entreprise recentrent désormais leurs priorités sur la gouvernance, la qualité de la récupération, l’architecture de contenu et l’organisation sémantique. Les performances de l’IA dépendent de plus en plus de la qualité de l’écosystème de contenu qui l’alimente.
La pression opérationnelle est déjà considérable. Selon une étude Forrester commanditée par Adobe, 64 % des organisations déclarent peiner à répondre aux exigences modernes de création de contenu, tandis que 68 % citent le manque de réutilisation du contenu comme un défi majeur. Ces difficultés ne se cantonnent plus aux seuls problèmes de documentation : elles pèsent de plus en plus sur la fiabilité, l’évolutivité et la crédibilité des systèmes d’IA d’entreprise.
Incapacité de l’IA à distinguer le contenu faisant autorité du contenu redondant
La duplication non maîtrisée constitue l’une des principales failles des environnements de documentation d’entreprise.
Les versions multiples de procédures similaires, les informations produit dupliquées dans différents référentiels, les terminologies contradictoires et les copies locales non gérées génèrent des frictions opérationnelles bien avant que l’IA entre en jeu. Mais lorsque les systèmes d’IA d’entreprise tentent d’extraire des connaissances depuis ces environnements, le problème prend une tout autre ampleur.
Les systèmes d’IA ne peuvent pas déterminer par eux-mêmes quelle version d’une procédure fait autorité, quelle spécification produit est à jour, ni quel contenu doit être privilégié par rapport à un autre. Sans workflows gouvernés garantissant une source de vérité unique, les systèmes d’extraction risquent de faire remonter des recommandations contradictoires ou obsolètes.
C’est pourquoi les stratégies modernes de contenu structuré misent de plus en plus sur une gouvernance du contenu centralisée, une réutilisation contrôlée et des pipelines de publication de référence. Les organisations qui déploient des systèmes d’IA ont besoin d’architectures documentaires capables de garantir la cohérence sur l’ensemble des canaux de diffusion.
Selon une étude IDC commanditée par Adobe, les organisations qui s’appuient sur Adobe Experience Manager Guides ont identifié des bénéfices opérationnels significatifs liés à la gestion centralisée du contenu, à la réutilisation et au contrôle des versions, notamment une productivité accrue, une cohérence renforcée et de meilleures expériences client.
Les pratiques modernes de gestion de contenu DITA répondent directement à ce défi. En appliquant le principe du source unique — rédiger le contenu une seule fois et le réutiliser dans de multiples sorties —, les organisations éliminent les duplications qui perturbent les systèmes d’extraction. La réutilisation du contenu est à la fois un levier d’efficacité et une stratégie de gouvernance de l’IA.
Ce constat s’inscrit dans les tendances plus larges du secteur. Forrester a également révélé que 69 % des personnes interrogées considèrent que des structures de contenu XML flexibles améliorent les capacités de réutilisation et de syndication, confirmant l’importance croissante des architectures de contenu structuré dans les opérations de contenu d’entreprise modernes.
Structures documentaires héritées : pensées pour les humains, pas pour les systèmes d’extraction
Les environnements de documentation traditionnels ont été conçus pour une lecture linéaire, et non pour la récupération sémantique.
Pendant des décennies, les organisations ont publié de volumineux manuels, de longs PDF et des bases de connaissances documentaires destinées à une consultation séquentielle. Si ces approches ont servi les workflows de publication traditionnels de façon raisonnable, elles créent aujourd’hui des défis majeurs pour les architectures de récupération par IA.
Les systèmes d’IA consomment l’information différemment des humains : ils récupèrent de petits fragments sémantiques, classent la pertinence de façon dynamique et assemblent des réponses à partir de multiples sources contextuelles.
Cela transforme entièrement les exigences opérationnelles en matière de documentation d’entreprise.
CCMS : un socle indispensable pour une documentation adaptée à l’IA.
Les documents monolithiques de grande envergure contiennent souvent un contexte excessif, des informations dupliquées ou obsolètes, une structure incohérente et des délimitations sémantiques floues. Les systèmes de récupération peinent à isoler le contenu le plus pertinent au sein de blocs de documentation surdimensionnés.
À l’inverse, un contenu modulaire et structuré permet aux organisations de décomposer l’information en composants réutilisables et sémantiquement cohérents, plus faciles à récupérer, à personnaliser, à gouverner et à réutiliser sur l’ensemble des canaux.
C’est pourquoi la création de contenu structuré et les systèmes de gestion de contenu par composants (CCMS) s’imposent de plus en plus comme des technologies fondamentales pour les entreprises prêtes pour l’IA. Un CCMS — tel que Adobe Experience Manager Guides — est une plateforme spécialisée conçue pour gérer du contenu structuré et réutilisable au niveau des rubriques plutôt qu’au niveau des documents. Contrairement à un CMS traditionnel, un CCMS applique des règles de gouvernance, de gestion des versions et des workflows de création structurée qui prennent en charge aussi bien la publication humaine que la récupération par IA à l’échelle de l’entreprise.
Nouvelle liste de contrôle pour un contenu prêt pour l’IA.
Un environnement de documentation prêt pour l’IA va bien au-delà des simples interfaces de chat ou des intégrations d’IA. Il repose sur des opérations de contenu rigoureuses qui garantissent une récupération fiable, une gouvernance solide, la réutilisation, l’évolutivité et la cohérence sémantique.
Les principes architecturaux suivants deviennent rapidement incontournables pour les organisations qui souhaitent créer des écosystèmes d’IA d’entreprise fiables.
1. Création de contenu structuré et modulaire
Les systèmes d’IA obtiennent de meilleurs résultats lorsque le contenu d’entreprise est modulaire, organisé sémantiquement et réutilisable.
La rédaction structurée — qu’il s’agisse de DITA XML, de rédaction par sujets ou d’autres approches de structuration du contenu — permet aux organisations de créer des composants de contenu modulaires, assemblables dynamiquement selon les produits, canaux, expériences et audiences. C’est le socle de la gestion moderne de contenu par composants, et elle s’impose désormais comme une exigence fondamentale pour les entreprises prêtes à tirer parti de l’IA. Plutôt que de gérer des documents isolés, les organisations administrent des assets de connaissance réutilisables.
« Lorsque nous aidons des organisations à migrer et à structurer de grands volumes de contenu d’entreprise, l’objectif ne se limite plus à l’efficacité de publication. Les entreprises se demandent désormais si leur contenu peut prendre en charge la récupération par IA, la recherche sémantique, la personnalisation, la conformité et les futures initiatives d’automatisation à grande échelle », a observé Bernard Aschwanden, PDG et cofondateur de WritemoreAI, sur LinkedIn.
Les avantages opérationnels sont considérables.
Premier avantage : une cohérence renforcée. Les composants de contenu partagés peuvent être mis à jour en un seul endroit, puis réutilisés dans de multiples sorties, réduisant ainsi les doublons et le risque d’informations contradictoires ou obsolètes.
Deuxième avantage : une meilleure qualité de récupération. Des sujets concis et sémantiquement cohérents permettent aux systèmes d’IA de retrouver les informations avec davantage de précision.
Troisième avantage : la personnalisation à grande échelle. Le contenu structuré permet aux organisations d’assembler dynamiquement des expériences adaptées à différentes audiences, variantes de produits, régions et canaux, sans dupliquer le contenu.
Une étude Forrester révèle que les organisations considèrent de plus en plus la gestion de contenu structuré comme un élément indispensable à la personnalisation, à l’évolutivité et à la livraison de contenu omnicanal.
La même étude révèle que 57 % des organisations s’attendaient à ce que les approches de contenu structuré améliorent le ROI de leur stratégie de contenu, tandis que plus de 80 % ont signalé une réduction des risques réglementaires, réputationnels, financiers et liés aux effectifs, après avoir adopté des pratiques de gestion de contenu structuré.
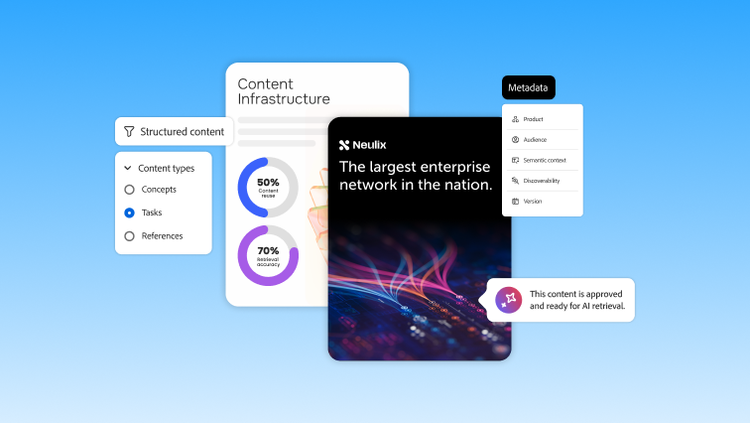
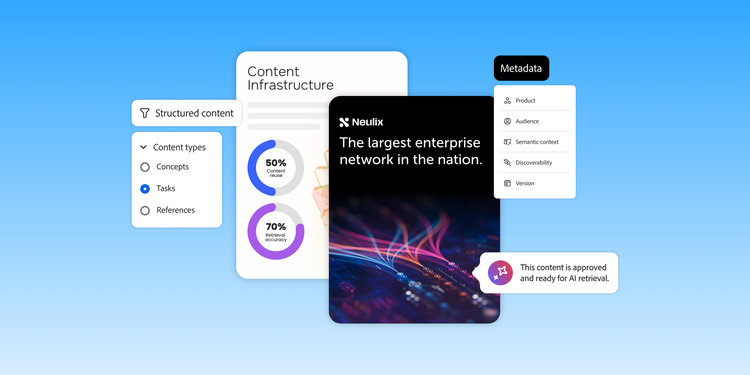
2. Métadonnées au service de la récupération sémantique.
Les métadonnées s’affirment rapidement comme l’une des couches opérationnelles les plus déterminantes dans l’IA d’entreprise.
Longtemps considérées comme une simple contrainte administrative, les métadonnées occupent aujourd’hui une place centrale dans la précision de la récupération, la découvrabilité, la personnalisation, la gouvernance et l’orchestration de l’IA.
Les systèmes d’IA modernes s’appuient fortement sur les métadonnées pour appréhender les relations entre les contenus, la pertinence pour l’audience, le statut du cycle de vie, l’applicabilité régionale, les associations de produits, les contraintes de conformité et le contexte sémantique.
Faute d’une stratégie rigoureuse en matière de métadonnées, les entreprises se retrouvent confrontées à des expériences de recherche incohérentes, une qualité de récupération médiocre, une personnalisation insuffisante et des opérations de contenu fragmentées.
La qualité des métadonnées influe de plus en plus sur la manière dont les systèmes d’IA d’entreprise classent, récupèrent et contextualisent l’information. En l’absence d’une gouvernance cohérente des métadonnées, les entreprises génèrent souvent des ambiguïtés sémantiques qui nuisent aussi bien aux expériences de recherche humaine qu’aux réponses générées par l’IA.
De solides architectures de métadonnées renforcent la compréhension des connaissances d’entreprise, aussi bien pour les équipes humaines que pour les systèmes automatisés.
Cela comprend :
- Métadonnées produit
- Métadonnées d’audience
- Applicabilité régionale et juridique
- Statut du cycle de vie
- Alignement taxonomique
- Classification sémantique
- Cartographie des relations
- Historique des versions
Dans les environnements de gestion de contenu structuré, notamment ceux basés sur DITA, les métadonnées ne sont pas ajoutées a posteriori — elles sont intégrées dès la rédaction via des éléments de prolog structurés, des attributs conditionnels et des schémas de sujets. Le contenu DITA s’avère ainsi intrinsèquement plus riche en métadonnées et mieux adapté à l’IA que la documentation non structurée, et nettement mieux taillé pour les architectures de récupération par IA.
À mesure que les entreprises déploient des systèmes d’assistance pilotés par l’IA et des expériences de recherche sémantique, la qualité des métadonnées devient directement liée à la fiabilité de l’IA.
3. Segmentation intelligente pour l’exploitation par l’IA.
La stratégie de segmentation est l’un des aspects les plus souvent négligés de la documentation prête pour l’IA.
Les systèmes de récupération par l’IA traitent rarement des manuels entiers ou des documents volumineux. Ils récupèrent plutôt de petits fragments de contenu conçus pour maximiser la pertinence contextuelle.
Une segmentation déficiente fragilise la qualité de la récupération de manière imperceptible.
Des segments trop volumineux réduisent la précision de la récupération et introduisent un contexte superflu. Des segments trop petits risquent de perdre leur sens sémantique ou de ne pas préserver la continuité procédurale.
Une segmentation intelligente oblige les entreprises à réfléchir attentivement aux aspects suivants :
- Délimitations sémantiques
- Cohérence procédurale
- Granularité thématique
- Unités de contenu réutilisables
- Préservation du contexte
- Optimisation de la récupération
C’est précisément là que les modèles de contenu structuré révèlent toute leur valeur.
Les rubriques modulaires bien conçues s’intègrent naturellement aux architectures de récupération IA, car elles organisent déjà les concepts, les tâches, les références, les avertissements, les conseils de dépannage et les étapes procédurales en unités cohérentes.
Les organisations les plus avancées reconnaissent de plus en plus que le découpage n’est pas un simple problème de configuration de la récupération. C’est une véritable discipline d’architecture de contenu.
« Les grands modèles de langage ne lisent pas la Documentation comme le font les humains. Ils récupèrent des fragments, des relations et des fenêtres de contexte. Les organisations doivent donc concevoir leur contenu pour la précision de la récupération, et non pour la seule efficacité de publication », a conclu Aschwanden.
4. Identifiants stables, références et traçabilité.
Une IA d’entreprise fiable exige des connaissances d’entreprise traçables.
À mesure que les organisations déploient des expériences d’assistance pilotées par l’IA, des copilotes internes et des systèmes d’assistance automatisée, la capacité à relier les réponses générées à des sources faisant autorité devient de plus en plus cruciale.
Les identifiants stables et les références contrôlées aident les organisations à maintenir :
- Traçabilité des citations
- Suivi des versions
- Auditabilité
- Justification de la conformité
- Lignée du contenu
- Cohérence intersystèmes
Ce point est particulièrement critique dans les secteurs réglementés, où les organisations doivent démontrer l’origine et la validité des directives opérationnelles.
Les références stables améliorent également la qualité de récupération, en permettant aux systèmes d’IA d’associer systématiquement les contenus connexes dans tous les environnements de publication.
À mesure que l’adoption de l’IA se généralise en entreprise, l’explicabilité et la traçabilité s’imposent comme des exigences opérationnelles de plus en plus incontournables.
5. Contrôle des versions et workflows de publication faisant autorité.
Les systèmes d’IA amplifient les failles de gouvernance.
Lorsque la documentation d’entreprise manque de workflows d’approbation rigoureux, de processus de publication contrôlés, de synchronisation des versions ou de supervision de la gouvernance, ces failles se révèlent clairement dans les expériences générées par l’IA.
Les organisations qui déploient des systèmes d’IA ont donc besoin d’une discipline opérationnelle rigoureuse concernant :
- Workflows d’approbation
- Gouvernance de publication
- Gestion des versions
- Actualité du contenu
- Processus de révision
- Autorisations basées sur les rôles
- Auditabilité
Ce point prend une importance toute particulière lorsque les organisations cherchent à déployer concrètement l’assistance générée par l’IA dans des environnements réglementés ou en contact direct avec les clients, où des informations obsolètes ou contradictoires peuvent engendrer des risques de conformité, de réputation et juridiques.
Les workflows encadrés par une gouvernance permettent de s’assurer que les systèmes d’IA récupèrent des informations à jour, approuvées et faisant autorité, plutôt que des contenus obsolètes ou incomplets.
Ce point devient particulièrement crucial lorsque la documentation vient en appui d’expériences orientées client, de conseils réglementaires, d’une intégration produit ou de procédures opérationnelles.
Les systèmes de gestion de contenu structuré fournissent de plus en plus les fondations de gouvernance nécessaires pour prendre en charge ces workflows à l’échelle de l’entreprise.
6. Architectures à source unique de vérité sur l’ensemble des canaux.
Aujourd’hui, les entreprises publient rarement leur contenu vers une seule destination.
La documentation produit alimente désormais les sites web, les portails d’assistance, les systèmes d’intégration client, les bases de connaissances, les API, les expériences mobiles, les moteurs de recherche intelligents, les plateformes de formation et les assistants IA.
En l’absence d’une gouvernance centralisée et de contenus sources réutilisables, les organisations dupliquent souvent leurs informations d’un canal à l’autre. À terme, cette pratique engendre des incohérences, une inefficacité opérationnelle et un risque de conformité accru.
Les organisations prêtes pour l’IA privilégient plutôt des architectures reposant sur une source de vérité unique, où les contenus structurés et gouvernés peuvent être assemblés dynamiquement et diffusés sur tous les canaux depuis des référentiels centralisés.
Cette approche favorise :
- Mises à jour plus rapides
- Cohérence renforcée
- Gouvernance améliorée
- Personnalisation optimisée
- Réduction des doublons
- Opérations plus évolutives
Elle pose également un socle plus solide pour les systèmes d’IA d’entreprise, dont le fonctionnement repose sur des connaissances faisant autorité et parfaitement synchronisées.
Pourquoi les architectures de contenu prêtes pour l’IA surpassent les opérations documentaires traditionnelles.
Les organisations qui modernisent leurs opérations de contenu réalisent souvent que la préparation à l’IA et l’excellence opérationnelle sont étroitement liées.
Les mêmes principes de contenu structuré qui améliorent la qualité d’extraction favorisent également la réutilisation, l’efficacité de traduction, la gouvernance, la personnalisation, l’évolutivité et la cohérence de publication.
Une étude IDC révèle que les organisations qui s’appuient sur Adobe Experience Manager Guides ont réalisé des gains significatifs en matière d’efficacité de gestion du contenu, de réutilisation du contenu, d’amélioration de la productivité et d’évolutivité opérationnelle.
Ces gains prennent une importance croissante, car les environnements de contenu sont eux-mêmes devenus des goulets d’étranglement opérationnels. S&P Global Research a également mis en évidence des frictions généralisées liées aux systèmes déconnectés, aux workflows fragmentés, au manque de responsabilités claires et aux pratiques de collaboration incohérentes — autant de facteurs qui affectent directement la qualité des connaissances d’entreprise et la préparation à l’IA.
Une étude de Forrester a de même relevé une cohérence du contenu renforcée, des capacités de personnalisation accrues, une diffusion omnicanale étendue et une réduction du risque opérationnel chez les organisations qui adoptent des approches de gestion de contenu structuré.
Cette convergence est bien plus déterminante que la plupart des organisations ne l’imaginent.
Les organisations ne modernisent plus leurs environnements documentaires dans le seul but d’améliorer l’efficacité de publication. Elles les modernisent parce que les systèmes d’IA d’entreprise dépendent désormais d’écosystèmes de contenu fiables, structurés et sémantiquement gouvernés.
Déploiement IA plus rapide, risques opérationnels réduits
Les organisations dotées d’environnements de contenu structuré et gouverné sont mieux à même de concrétiser leurs initiatives IA à l’échelle de l’entreprise.
Les systèmes de récupération sont plus performants lorsque le contenu est modulaire et organisé sémantiquement. Les métadonnées améliorent la découvrabilité et la fiabilité de la récupération. La gouvernance des versions réduit le risque d’exposer des informations obsolètes. Des workflows contrôlés renforcent la confiance dans les résultats.
Ces capacités opérationnelles, combinées, réduisent les frictions lors du déploiement de l’IA tout en limitant les risques liés à des résultats inexacts ou incohérents.
Cet aspect est particulièrement crucial pour les entreprises évoluant dans des environnements réglementés, où l’exactitude du contenu et sa traçabilité sont indispensables.
Amélioration de l’expérience client grâce à une récupération fiable
Les clients attendent désormais des réponses immédiates, contextuelles et fiables.
Les systèmes d’assistance propulsés par l’IA, les expériences de recherche intelligente et les copilotes d’entreprise s’intègrent de plus en plus dans la pile d’expérience client moderne.
Ces expériences ne portent leurs fruits que si l’architecture de connaissances sous-jacente est fiable.
Cette confiance dépend de plus en plus de la capacité des organisations à maintenir un contenu source faisant autorité, une gouvernance cohérente, des mises à jour synchronisées et des architectures pensées pour la récupération, sur chaque canal de diffusion.
Les organisations disposant d’environnements de documentation structurés, réutilisables et gouvernés sémantiquement sont mieux positionnées pour offrir :
- Des expériences d’assistance plus rapides
- Un meilleur libre-service
- Meilleur accueil
- Une récupération plus précise par l’IA
- Une personnalisation renforcée
- Des expériences omnicanal cohérentes
Cela relie directement les opérations de contenu à la stratégie de création d’expériences client.
Personnalisation à grande échelle sans duplication de contenu
La personnalisation à l’échelle de l’entreprise exige de la modularité.
Les organisations qui opèrent sur plusieurs produits, régions, environnements réglementaires, langues ou types de clients ne peuvent pas développer efficacement la personnalisation à l’échelle en s’appuyant sur une documentation statique et redondante.
Les modèles de contenu structuré permettent aux organisations d’assembler dynamiquement des expériences ciblées à partir de composants de contenu réutilisables, gérés via des workflows centralisés.
Cette approche réduit les redondances tout en renforçant l’agilité.
La même architecture structurée qui prend en charge la publication et la réutilisation de documentation omnicanale renforce également la qualité de récupération par l’IA, en préservant la cohérence entre les variantes de contenu.
Les organisations qui s’imposent grâce à l’IA abordent la gouvernance du contenu différemment.
L’IA d’entreprise pousse les organisations à repenser la documentation dans son ensemble.
Pendant longtemps, la documentation était considérée comme une exigence opérationnelle secondaire, élaborée une fois les produits finalisés.
Aujourd’hui, la documentation joue un rôle croissant d’intelligence opérationnelle au service des systèmes d’assistance, des expériences d’intégration, de la récupération sémantique, de la recherche intelligente, des moteurs de personnalisation, des workflows de conformité et de l’assistance pilotée par l’IA.
« La plupart des organisations considèrent encore la documentation comme un problème d’édition. L’IA révèle qu’il s’agit en réalité d’un problème d’architecture de la connaissance. Si le contenu est fragmenté, dupliqué ou déconnecté de toute gouvernance, les systèmes d’IA en hériteront les mêmes faiblesses à l’échelle », a déclaré Aschwanden.
Cette évolution transforme profondément l’importance stratégique du contenu structuré.
Pour développer des systèmes d’IA d’entreprise fiables, les organisations auront de plus en plus besoin de :
- Gestion gouvernée du contenu
- Création de contenu structuré
- Métadonnées sémantiques
- Rubriques modulaires et réutilisables
- Workflows contrôlés
- Architectures de publication fondées sur une source de vérité
- Références traçables
- Conception de contenu orientée récupération
L’avantage concurrentiel s’étendra bien au-delà des organisations disposant des modèles les plus imposants ou des initiatives d’IA les plus médiatisées.
L’avenir appartiendra aux organisations qui disposent des connaissances d’entreprise les plus fiables.
Maturité IA : bien avant le modèle.
De nombreuses organisations abordent encore leurs initiatives d’IA d’entreprise principalement comme de simples projets technologiques.
En réalité, les systèmes d’IA performants reposent largement sur les choix d’architecture de contenu effectués en amont.
La rédaction structurée, la gouvernance des métadonnées, la segmentation intelligente du contenu, les références stables, les modèles de contenu réutilisables et les workflows de source de vérité influencent directement la qualité d’extraction, la personnalisation, l’explicabilité, l’évolutivité et la confiance au sein de l’organisation.
À mesure que l’adoption de l’IA d’entreprise s’accélère, les organisations qui modernisent leur écosystème documentaire sont nettement mieux positionnées pour déployer des expériences d’IA fiables à grande échelle.
L’avenir de l’IA d’entreprise va bien au-delà des seuls modèles.
Il se bâtira sur des connaissances d’entreprise gouvernées, structurées et organisées de façon sémantique.
Checklist du contenu prêt pour l’IA en entreprise.
Les organisations souhaitant évaluer leur état de préparation documentaire pour leurs initiatives d’IA d’entreprise peuvent s’appuyer sur la liste de contrôle suivante comme cadre d’évaluation pratique.
Structure et modularité
- Le contenu est-il rédigé sous forme de composants structurés et réutilisables — tels que des rubriques DITA — plutôt que sous forme de documents monolithiques ?
- Le contenu peut-il être assemblé dynamiquement selon les canaux, les produits et les audiences ?
- Les frontières sémantiques entre les sujets sont-elles clairement définies ?
- Le contenu dupliqué est-il réduit au minimum dans l’ensemble des référentiels ?
- Est-il possible de mettre à jour des rubriques individuellement sans réécrire l’intégralité des documents ?
Métadonnées et taxonomie
- Le contenu est-il systématiquement balisé avec des métadonnées relatives au produit, à l’audience, au cycle de vie et à la région ?
- La taxonomie reste-t-elle cohérente dans l’ensemble des référentiels et des canaux de diffusion ?
- Les systèmes d’IA sont-ils capables d’identifier de façon fiable les relations entre les assets de contenu ?
- Les standards de métadonnées sont-ils régis de manière centralisée ?
- Le contenu est-il enrichi de classifications sémantiques qui améliorent sa découvrabilité ?
Extraction et segmentation
- Le contenu est-il optimisé pour les systèmes d’extraction plutôt que pour la seule lecture linéaire ?
- Les segments de contenu sont-ils sémantiquement cohérents et préservent-ils le contexte ?
- Les systèmes d’extraction sont-ils capables d’isoler efficacement des réponses faisant autorité ?
- Les sujets procéduraux sont-ils segmentés de manière appropriée pour être consommés par l’IA ?
- La stratégie de segmentation est-elle alignée sur l’architecture de contenu réutilisable ?
Gouvernance et traçabilité
- Les workflows de publication faisant autorité sont-ils appliqués de manière cohérente ?
- Les réponses générées par l’IA peuvent-elles être retracées jusqu’au contenu source gouverné ?
- La gestion des versions et les approbations sont-elles synchronisées sur l’ensemble des canaux de livraison ?
- Les exigences d’auditabilité et de conformité sont-elles intégrées aux opérations de contenu ?
- Des identifiants stables sont-ils maintenus sur l’ensemble des composants de contenu réutilisables ?
Gestion de la source de vérité
- L’organisation dispose-t-elle d’un contenu source centralisé et réutilisable ?
- Les copies locales et les doublons non gérés sont-ils réduits au minimum ?
- Les mises à jour sont-elles propagées de manière cohérente sur l’ensemble des expériences et des plateformes ?
- Les responsables du contenu peuvent-ils identifier clairement les versions de référence de l’information ?
- La gouvernance est-elle assurée sur l’ensemble des canaux de publication ?
Préparation à l’IA
- L’organisation s’appuie-t-elle sur un CCMS DITA ou une plateforme de création structurée prenant en charge la publication encadrée, le contrôle de version et la conception de contenu orientée récupération ?
- Les systèmes d’IA d’entreprise sont-ils en mesure de distinguer le contenu faisant autorité du contenu obsolète ?
- La documentation est-elle conçue dès l’origine pour faciliter la récupération ?
- Le contenu est-il structuré pour garantir l’explicabilité et la fiabilité des réponses de l’IA ?
- Les systèmes d’IA peuvent-ils récupérer du contenu modulaire avec suffisamment de contexte et de précision ?
- L’architecture de documentation prend-elle en charge la personnalisation à grande échelle, l’automatisation et la recherche sémantique ?