Sind eure Unternehmensdaten bereit für das Training eines eigenen KI-Modells? | Adobe Deutschland
View this page in English (US).Continue

Sind eure Unternehmensdaten bereit für das Training eines eigenen KI-Modells?

Laut IBM Institute for Business Value stimmen nur 29 % der Technologieverantwortlichen voll zu, dass ihre Unternehmensdaten die Anforderungen an Qualität, Zugänglichkeit und Sicherheit erfüllen, die für die Skalierung generativer KI nötig sind. Für Kreativ- und Marketing-Teams, die eigene KI-Modelle erkunden, hat diese Lücke direkte Konsequenzen. Ein Modell, das auf inkonsistenten Kampagnenbildern, veralteten Marken-Assets oder Dateien mit unklaren Nutzungsrechten trainiert wird, liefert Ergebnisse, die nicht den Markenstandards entsprechen, aufwendige Nachbearbeitung erfordern oder Governance-Risiken mit sich bringen. Bevor Teams ein eigenes Modell für markenkonforme Visuals trainieren, sollten sie prüfen, ob ihre vorhandenen Assets die erwarteten Ergebnisse überhaupt unterstützen können.

Diese Bewertung basiert auf vier Metriken: Qualität, Quantität, Aufbereitung und Governance. Jede davon beeinflusst, wie gut ein Modell aus euren Assets lernen und nützliche Ergebnisse für kreative Workflows liefern kann.

Dieser Blog-Artikel behandelt:

Was sind KI-fähige Daten?

KI-fähige Daten sind präzise, konsistent, relevant und für Machine Learning geeignet. Für das Training eigener KI-Modelle bedeutet das: Die Assets müssen aussagekräftig genug sein, um einem Modell die Muster, Stile und Standards beizubringen, die es benötigt, um markenkonforme Inhalte zu reproduzieren.

Kreativ-Teams in Unternehmen starten das Training eigener KI-Modelle häufig mit den Assets, die bereits vorhanden sind, darunter Kampagnenbibliotheken, Produktfotografien, Design-Dateien und freigegebene Markenbilder, die in einem System für Digital Asset Management (DAM) gespeichert sind. Ein DAM macht diese Assets durchsuchbar, strukturiert und leichter Team-übergreifend nutzbar. Doch der einfache Zugriff auf visuelle Assets ist eine Sache. Ob diese Assets als Trainingsdaten für ein eigenes KI-Modell geeignet sind, ist eine ganz andere Frage.

Dieser Unterschied ist entscheidend: Eigene generative KI-Modelle unterscheiden sich grundlegend von allgemeinen Basismodellen. Basismodelle werden auf Breite trainiert – über viele Themen, Stile und Anwendungsfälle hinweg. Eigene Modelle hingegen sind auf Präzision ausgelegt. Sie benötigen einen fokussierten Datensatz, der die visuelle Sprache der Marke, kreative Standards und die gewünschten Ausgaben widerspiegelt.

Ein DAM-System hilft Teams in der Regel dabei, fertige kreative Inhalte zu finden und zu verteilen. Ein Trainingsdatensatz erfüllt eine andere Aufgabe: Er soll einem Modell beibringen, welche visuellen Muster es erkennen, reproduzieren und priorisieren soll. Daher sollten die Assets genau die Ausgaben widerspiegeln, die das Modell erzeugen soll – und nicht einfach alles, was die Marke bisher produziert hat.

Bei generativer KI für visuelle Inhalte ist die Bereitschaft stark auf den Anwendungsfall bezogen. Ein Datensatz für die Generierung von Lifestyle-Fotos stellt andere Anforderungen als einer für Produktaufnahmen, Kampagnenkonzepte, Social-Media-Varianten oder lokalisierte kreative Inhalte. Eine breite Sammlung verfügbarer Marken-Assets mag wie ein praktischer Ausgangspunkt wirken. Trainingsdaten brauchen jedoch einen engeren Filter. Der Datensatz sollte gezielt die visuellen Muster stärken, die das Modell erlernen soll.

Bewertung der Datenqualität für das Training eigener KI-Modelle.

KI-Datenqualität geht weit über das äußere Erscheinungsbild eines Bildes hinaus. Unternehmens-Teams müssen prüfen, ob jedes Asset dem Modell hilft, die richtigen kreativen Muster zu erlernen.

Bei kreativen und visuellen Trainingsdaten ist Qualität eng mit dem tatsächlichen Nutzen verknüpft. Ein Bild kann professionell produziert sein und dennoch ungeeignet für das Training sein – etwa weil es eingestellte Produktlinien zeigt, veraltete Markenelemente enthält, Umgebungen darstellt, die nicht mehr der aktuellen Positionierung entsprechen, oder visuelle Stile einführt, die der Markenausrichtung widersprechen.

Eine gezielte Qualitätsprüfung hilft Teams dabei, verfügbare Assets von solchen zu trennen, die für das Training eigener KI-Modelle wertvoll sind. Dabei sollten vier Bereiche im Fokus stehen:

  • Genauigkeit und Markenrelevanz. Trainings-Assets sollten die Marke so zeigen, wie sie heute existiert. Assets aus eingestellten Kampagnen, veralteten Markensystemen, alter Produktverpackung, früheren Logovarianten oder kreativen Ausrichtungen, die das Unternehmen nicht mehr repräsentieren, sollten ausgeschlossen werden. Metadaten können dabei helfen, Datumsangaben, Märkte, Kampagnen und Nutzungshistorien zu identifizieren – aber Kreativ- und Marken-Teams müssen dennoch prüfen, ob jedes Asset das gewünschte Ergebnis widerspiegelt.
  • Visuelle Konsistenz. Assets sollten auf Einheitlichkeit in Bereichen wie Beleuchtung, Bildkomposition, Farbgestaltung, Kamerawinkel, Hintergrundgestaltung, Bildausschnitt, Auflösung und Dateiqualität geprüft werden. Ein Datensatz, der einen klaren Produktfotografie-Stil vermitteln soll, sollte beispielsweise nicht stark auf Lifestyle-Aufnahmen mit dramatischen Schatten, strukturierten Hintergründen oder saisonalen Overlays setzen. Solche Assets mögen anderweitig nützlich sein, können jedoch die Konsistenz des Trainings-Sets schwächen.
  • Abdeckung und Vielfalt. Die Datenabdeckung sollte die gesamte Bandbreite der Aufgaben widerspiegeln, für die das Modell eingesetzt werden soll. Ein Modell, das vorwiegend auf einer Produktlinie, einem Markt oder einem Kampagnenstil basiert, liefert in diesem Kontext zwar gute Ergebnisse, kommt aber bei größerer Vielfalt schnell an seine Grenzen. Teams sollten prüfen, ob der Datensatz die richtige Mischung aus Produkten, Formaten, Regionen, Zielgruppen, Saisons und Anwendungsfällen enthält – abgestimmt auf den geplanten Einsatz des Modells.
  • Sauberkeit und Ausschlüsse. Saubere Trainingsdaten schließen Assets aus, die unerwünschte Ausgaben oder rechtliche Risiken verursachen könnten. Auszuschließen sind Bilder mit Wasserzeichen, unklaren Stocklizenzen, veralteten Haftungsausschlüssen, eingebetteten Textüberlagerungen, sichtbarem Platzhaltertext, verzerrten Logos oder inkonsistenten Drittanbieter-Markenzeichen. Eingebetteter Text verdient besondere Aufmerksamkeit: Das Modell könnte Headlines übernehmen und als Teil des visuellen Stils verwenden – einschließlich Sprache und Werbetexten.

Asset-Volumen vs. kreative Bandbreite.

Wie viele Trainingsdaten ein benutzerdefiniertes KI-Modell benötigt, hängt vom jeweiligen Anwendungsfall, der Komplexität des gewünschten Outputs, dem erforderlichen Maß an kreativer Variation und der Spezifität der Markenstandards ab.

Ein spezialisiertes Modell kann mit einem kleineren, fokussierten Datensatz gut funktionieren. Ein Modell zur Erzeugung konsistenter Produktdetailbilder beispielsweise benötigt weder das gleiche Volumen noch die gleiche Vielfalt wie eines, das Kampagnenkonzepte über Regionen, Saisons, Zielgruppen und Kanäle hinweg unterstützen soll. Entscheidend ist, ob der Datensatz dem Modell genug Spielraum bietet, um die gestellten Aufgaben zu bewältigen.

Hohes Volumen allein kann trügerisch sein. Ein Datensatz mit Hunderten nahezu identischer Produktbilder mag umfangreich wirken, liefert aber nur begrenzten Trainingswert. Ist das Ausgangsmaterial zu begrenzt oder zu gleichförmig, können die Ergebnisse den Original-Assets zu ähnlich sein oder zu wenig Variation für den Kampagneneinsatz bieten.

Teams mit begrenztem Asset-Volumen können einen soliden Datensatz durch kontrollierte Variation erweitern – etwa durch freigegebene Zuschnitte, alternative Kompositionen, Helligkeitskorrekturen oder Variationen des Aufnahmewinkels. Solche Ergänzungen sind dann besonders wirksam, wenn sie den beabsichtigten Output des Modells klarer definieren.

Ein schrittweises Vorgehen kann das Risiko zusätzlich minimieren. Beginnt mit einem kuratierten Set hochwertiger Assets, trainiert ein erstes Modell und prüft, wo die Ergebnisse hinter den Erwartungen zurückbleiben. Diese erste Testrunde zeigt, ob der Datensatz mehr Produktvielfalt, sauberere Hintergründe, zusätzliche Perspektiven, breitere regionale Beispiele oder eine engere Markenfilterung benötigt.

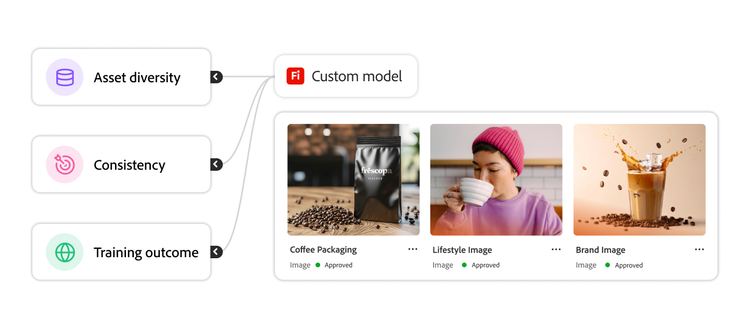
Infografik, die veranschaulicht, wie Asset-Vielfalt, Konsistenz und Abdeckung die Trainingsergebnisse beeinflussen.

Asset-Vorbereitung vor dem Training eigener KI-Modelle.

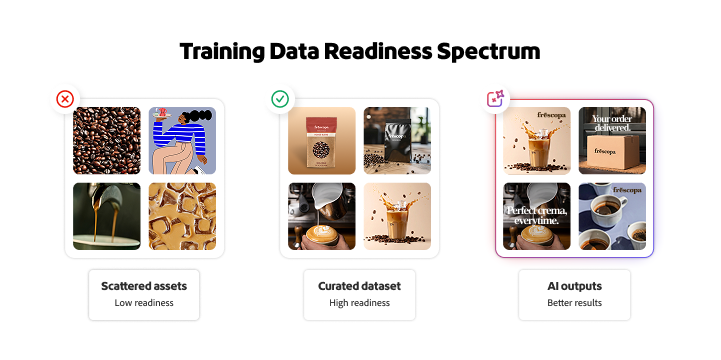
Trainingsdaten müssen sorgfältig kuratiert werden, bevor ein benutzerdefiniertes KI-Modell sie nutzen kann. Eine allgemeine Asset-Bibliothek enthält zwar oft brauchbare Elemente, doch ein Trainingsdatensatz erfordert eine engere, gezieltere Struktur. Teams müssen genau wissen, welche Assets in den Datensatz gehören, warum sie dort aufgenommen werden und nach welchen Kriterien die übrigen ausgeschlossen wurden.

Der Ausgangspunkt ist der geplante Einsatzzweck des Modells. Ein Modell für Produktdetailseiten, Varianten für bezahlte Social-Media-Kampagnen, Kampagnenkonzepte oder Charakterillustrationen benötigt jeweils unterschiedliche Quellmaterialien. Bei der Auswahl sollten aktuelle Markengenehmigung, Ausgabestil, Produktabdeckung, Formatanforderungen, Nutzungsrechte und regionale Relevanz berücksichtigt werden. So wird verhindert, dass der Datensatz zu einem unstrukturierten Sammelsurium verfügbarer Assets wird.

Nach der Auswahl müssen die Assets so strukturiert werden, dass sie das Training und das spätere Modell-Management unterstützen. Einheitliche Benennungskonventionen, Metadaten und Taxonomien sorgen dafür, dass der Datensatz einfach zu überprüfen, zu aktualisieren und zu auditieren ist. Sinnvolle Metadaten können Kampagnenname, Region, Produktkategorie, Asset-Typ, Erstellungsdatum, Genehmigungsstatus, Nutzungsrechte, Agentur oder Fotografin bzw. Fotograf, Zielgruppe, Kanal und Markenstil umfassen.

Eine klare Struktur erleichtert auch das erneute Training des Modells. Wenn sich Produkte, Kampagnen oder Markenstandards weiterentwickeln, müssen Teams das Modell möglicherweise mit neuen Assets aktualisieren oder ältere entfernen. Ein gut strukturierter Datensatz macht solche Anpassungen deutlich effizienter, als bei null anzufangen.

Die rechtliche Prüfung sollte erfolgen, bevor Assets in den Trainingsdatensatz aufgenommen werden. Teams müssen sicherstellen, dass jedes Asset nicht nur für die Kampagnendistribution, sondern ausdrücklich auch für das KI-Training freigegeben ist. Dies gilt besonders für Stockfotografie, von Agenturen produzierte Assets, Influencer-Inhalte, Talentfotografie, lizenzierte Kunstwerke und Assets, die Marken von Drittparteien enthalten.

In die Vorbereitung sollten außerdem alle Teams einbezogen werden, die für die Qualität von Kreativmaterial, Marken-Governance, rechtliche Risiken und technische Kontrolle verantwortlich sind. Kreativ-Teams können Assets identifizieren, die den gewünschten Stil widerspiegeln. Marken-Teams können die Übereinstimmung mit aktuellen Richtlinien bestätigen. Rechts-Teams können Genehmigungen und Rechte validieren. IT- oder Governance-Teams können Sicherheits-, Zugriffs- und Speicheranforderungen prüfen. Eine frühzeitige Einbindung aller Stakeholderinnen und Stakeholder verringert das Risiko, dass Probleme mit Assets, Rechten oder Governance erst entdeckt werden, wenn das Training des benutzerdefinierten KI-Modells bereits begonnen hat.

Datensicherheit und Governance.

Daten-Governance muss von Anfang an in das Modelltraining integriert sein. Sobald ein eigenes Modell trainiert wurde, lassen sich Fragen zu Asset-Rechten, Zugriff, Herkunft und Output-Freigabe nur noch schwer klären.

Jeder Trainingsdatensatz sollte einen Rechtenachweis enthalten, der die Asset-Eigentümerschaft, Lizenzbedingungen, Nutzungsbeschränkungen und den Genehmigungsstatus für KI-Training dokumentiert. Geht nicht davon aus, dass ein Asset, das für Marketing-Zwecke freigegeben ist, automatisch auch für das Modelltraining genutzt werden darf. Stockverträge, Agenturverträge, Talentfreigaben und lizenziertes Bildmaterial können Einschränkungen enthalten, die generative KI nicht berücksichtigen.

Unternehmens-Teams sollten außerdem wissen, wo Trainingsdaten gespeichert sind, wer Zugriff darauf hat und ob sie für das Training gemeinsam genutzter oder externer Modelle verwendet werden dürfen. Proprietäre Marken-Assets, unveröffentlichte Produkt-Bildmaterialien und vertrauliche Kampagnenmaterialien erfordern besonderen Schutz.

Zugriffssteuerung und Datenherkunft greifen ineinander und sorgen für klare Verantwortlichkeiten im gesamten Trainingsprozess. Teams sollten festlegen, wer Assets hochladen, Datensätze bearbeiten, Trainings starten, Output prüfen, Modelle genehmigen und Modelle in Produktions-Workflows einsetzen darf. Zudem sollte nachvollziehbar sein, welche Assets für welche Modellversion genutzt wurden, wann das Training stattfand, wer den Datensatz freigegeben hat und was sich im Laufe der Zeit verändert hat. Rollenbasierte Berechtigungen und Audit-Protokolle zusammen minimieren das Risiko unerlaubter Änderungen, unklarer Eigentumsverhältnisse oder des Trainings mit falschen Assets.

Regulatorische Anforderungen können sich sowohl auf Trainingsdaten als auch auf den Output auswirken. Unternehmen, die in mehreren Regionen tätig sind, sollten Datenschutzgesetze, KI-Regulierungen, Branchenstandards und interne Compliance-Richtlinien berücksichtigen. Dies gilt besonders, wenn Assets Personen, Standorte, gesundheitsbezogene Aussagen, Finanzinformationen oder regionsspezifische Hinweispflichten beinhalten.

Marken-Governance für KI-generierte Inhalte.

Governance bedeutet auch, die Markenintegrität zu schützen. Ein Modell mag Output schnell liefern. Dennoch braucht der Output klare Standards, bevor er in Produktions-Workflows einfließt.

Beginnt mit genehmigten visuellen Standards, die festlegen, welche Anforderungen kreative Assets erfüllen müssen – von Komposition und Farbgestaltung über Produktdarstellung, Beleuchtung und Hintergrundstil bis zum Einsatz von Personen, Logos und regionalen Vorgaben. Definiert anschließend klare Prüfkriterien für die Ausgabe. Menschliche Prüfende müssen wissen, welche Standards einzuhalten sind, was überarbeitet werden muss und was abgelehnt werden sollte. Ablehnungskriterien können verzerrte Produkte, ungenaue Verpackungsdarstellungen, falsche Markenfarben, unrealistische menschliche Merkmale, sichtbare Textfehler oder Grafiken und Videos umfassen, die regionalen Richtlinien widersprechen.

Prüf-Workflows für Kreativmaterial brauchen klare Eskalationswege. Wenn eine Ausgabe Fragen zu Rechten, Produktgenauigkeit, Markendarstellung oder Compliance aufwirft, müssen Prüfende wissen, wie sie die Abweichung melden und welches Team sie benachrichtigen sollen – bevor das Asset freigegeben wird. So können Unternehmen die Produktion beschleunigen, ohne dabei Abstriche bei der kreativen Qualität oder beim Markenimage zu machen.

Infografik zum Zusammenhang zwischen Datenzuständigkeit, Zugriffssteuerung, Compliance-Anforderungen und der Nachvollziehbarkeit von Modellausgaben.

Ein solides Fundament für das Training eigener KI-Modelle.

Datenbereitschaft muss sich gemeinsam mit den unterstützten Modellen weiterentwickeln. Wenn Teams eigene KI-Modelle trainieren, evaluieren, aktualisieren und steuern, müssen die Trainingsdaten kontinuierlich mit Markenstandards, kreativen Prioritäten und Produktions-Workflows abgeglichen werden. Ein heute solider Datensatz kann in sechs Monaten veraltet sein – nämlich dann, wenn er die aktuelle kreative Ausrichtung oder die Unternehmensprioritäten nicht mehr widerspiegelt.

Für Unternehmen, die eigener KI-Modelle trainieren möchten, ist ein gezielter Review entscheidend – mit Blick auf Qualität, Quantität, Aufbereitung und Governance. Diese vier Metriken helfen Teams dabei zu ermitteln, ob ihre vorhandenen Assets bereit für das Modelltraining sind oder ob zunächst grundlegende Lücken geschlossen werden müssen.

Adobe Firefly Custom Models ist für Teams konzipiert, die markenkonforme Bildvarianten mit Modellen erstellen möchten, die anhand eigener Assets trainiert wurden. Adobe Firefly Custom Models unterstützt Workflows für Training, Vorschau, Test, Veröffentlichung, Freigabe, Verwaltung und erneutes Training eigener Modelle. So können Teams markenkonformen Content skaliert erstellen – mit kontrolliertem Zugriff und Isolierung auf Organisationsebene.

Entdeckt, was Adobe Firefly Custom Models für Unternehmens-Teams leisten kann.

Empfehlungen für euch.

Finden wir gemeinsam heraus, wie Adobe eurem Unternehmen helfen kann.

Jetzt loslegen