Qu’est-ce que la transformation des données ? Processus, types et outils
09-15-2026
Tout échec en matière de business intelligence suit le même schéma : des tableaux de bord irréprochables en apparence, reposant sur des données qui n’ont jamais été correctement préparées. La transformation des données est le processus qui permet d’éviter ces écueils — et la comprendre constitue la première étape vers des analytics auxquels vous pouvez véritablement faire confiance.
Cet article aborde les points suivants :
- Qu’est-ce que la transformation des données ?
- Quels sont les principaux types de transformation des données ?
- Comment fonctionne le processus de transformation des données ?
- Quelle est la différence entre ETL et ELT ?
- Quels sont les avantages de la transformation des données pour les entreprises ?
- Quels défis pose la transformation des données ?
- Comment évaluer les outils de transformation des données ?
- Comment choisir la bonne approche de transformation des données ?
Qu’est-ce que la transformation des données ?
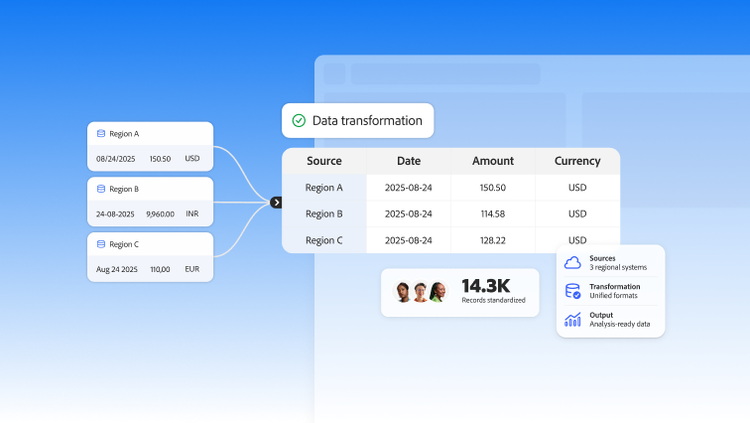
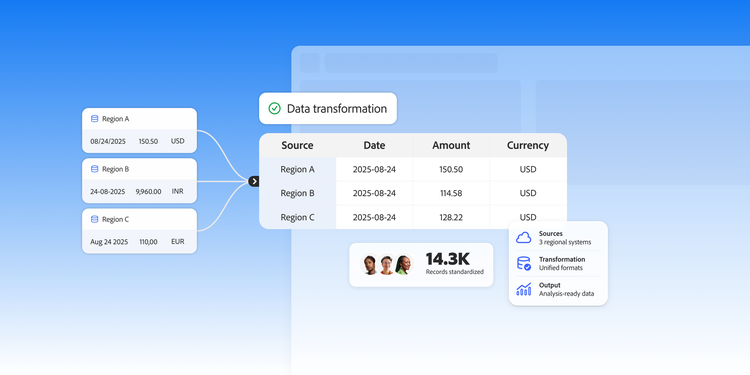
La transformation des données est le processus qui consiste à convertir des données brutes depuis leur format ou structure d’origine vers un format propre et cohérent, prêt pour l’analyse ou l’intégration dans des systèmes en aval. Prenons l’exemple d’un retailer qui consolide des enregistrements de ventes issus de trois bases de données régionales, chacune utilisant des formats de date et des codes de devise différents. Avant qu’un outil de reporting puisse comparer les résultats entre régions, les données doivent être transformées en un schéma unifié comportant des dates normalisées, une devise commune et des noms de champs cohérents.
Au sein d’un pipeline de données plus large, la transformation s’intercale entre l’ingestion (collecte des données) et le chargement (envoi des données vers un entrepôt ou une plateforme analytics). Les différents acteurs interviennent à des étapes distinctes du processus : les ingénieurs et ingénieures data définissent les règles, les analystes métier valident les résultats, et les équipes en charge des opérations marketing exploitent ces données dans des tableaux de bord, des outils de segmentation et des plateformes d’activation.
La transformation devient indispensable dès qu’une organisation gère plusieurs sources de données. Un système GRC unique a rarement besoin de transformation. Mais dès que ce GRC se connecte à une plateforme publicitaire, un outil de gestion des tickets d’assistance et un système d’analytics web, chaque nom de champ, type de données et format d’enregistrement devient source de conflit potentiel. La transformation résout ces conflits de manière systématique — non pas par des corrections ponctuelles, mais grâce à une logique répétable et structurée, appliquée à chaque transfert de données entre systèmes.
Cette distinction est fondamentale : la transformation des données n’est pas une simple opération ponctuelle de nettoyage. C’est une discipline continue, au cœur de tout pipeline. Les systèmes sources évoluent, de nouveaux champs apparaissent et les formats dérivent. Les organisations qui considèrent la transformation comme un projet plutôt que comme un processus voient la qualité de leurs données s’éroder en quelques mois.
Principaux types de transformation des données
Les transformations de données se répartissent en plusieurs catégories distinctes, chacune répondant à une classe spécifique de problèmes de qualité des données. Comprendre ces types permet aux équipes de concevoir des pipelines qui couvrent l’ensemble des modes de défaillance possibles, et pas seulement les plus évidents.
- Normalisation restructure les valeurs selon une échelle ou un format standard. Par exemple, convertir tous les numéros de téléphone au format E.164 (+1XXXXXXXXXX) garantit leur cohérence entre un GRC et une plateforme de messagerie. Sans normalisation, un client dont le numéro de téléphone est enregistré sous la forme "(555) 867-5309" dans un système et «15558675309» dans un autre peut apparaître comme deux personnes différentes.
- Agrégation synthétise les enregistrements granulaires en métriques récapitulatives. Un tableau de bord financier qui requiert des totaux de revenus journaliers tire parti de l’agrégation des revenus par transaction en totaux quotidiens lors de la transformation, évitant ainsi de traiter des millions de lignes individuelles au moment de la requête. Le reporting en aval y gagne en rapidité et en efficacité économique.
- Filtrage élimine les enregistrements ne satisfaisant pas aux critères de qualité ou de pertinence. L’exclusion des comptes de test du décompte de clients avant le calcul du taux d’attrition en est un exemple courant. Tout compte de test non filtré lors de la transformation fausse l’ensemble des mesures en aval qui dépendent du décompte de clients.
- Mappage et renommage des champs harmonisent les noms de champs incohérents entre les sources. Un système stocke «cust_id» tandis qu’un autre stocke "customer_identifier." La transformation associe les deux à un identifiant canonique unique, ‹customer_id›, afin que les jointures et les recherches fonctionnent correctement dans l’entrepôt de données.
- Enrichissement ajoute des attributs supplémentaires à partir d’une source secondaire. L’ajout de données firmographiques — telles que la taille de l’entreprise et le secteur d’activité — à un enregistrement de contact issu d’un fournisseur tiers constitue une étape d’enrichissement typique. Pour explorer les modèles d’implémentation plus en détail, consultez notre article sur l’enrichissement des données.
- Anonymisation et masquage remplacent les valeurs à caractère personnel par des jetons ou des équivalents synthétiques. Remplacer les adresses e-mail par des identifiants hachés avant de partager les données avec un prestataire d’analytics constitue une application standard. Pour les détails d’implémentation, consultez les techniques d’anonymisation des données.
- La conversion de type modifie le type de données d’un champ. Convertir une date au format chaîne («2024-01-15») en un type date approprié permet à un outil de BI de trier et de filtrer par période calendaire. Sans conversion de type, les comparaisons de dates risquent d’échouer ou de générer des ordres de tri incorrects.
Dans la pratique, la plupart des pipelines appliquent plusieurs types de transformation en séquence. Un pipeline de données marketing peut filtrer le trafic de robots, mapper les noms de champs, normaliser les formats de date et agréger les données en comptages de sessions quotidiennes, avant même que celles-ci n’atteignent la couche de reporting.
Fonctionnement du processus de transformation des données
Le processus de transformation des données suit une séquence d’étapes structurées. Ignorer l’une de ces étapes génère des erreurs en aval, souvent invisibles jusqu’à ce qu’une décision stratégique soit prise à partir de données corrompues. Pour des illustrations concrètes de chaque étape en pratique, consultez notre dossier consacré aux exemples de transformation des données.
Étape 1 : Profilage des données sources. Avant de rédiger toute règle de transformation, les analystes auditent les données entrantes pour détecter les valeurs nulles, les doublons, les incompatibilités de types et les valeurs aberrantes. Un passage de profilage sur une exportation GRC peut révéler que 12 % des enregistrements ne comportent pas d’adresse e-mail, que le champ «state» contient à la fois des abréviations et des noms complets, et que quelques enregistrements présentent des dates de création en 1900. Le profilage permet de cerner l’ampleur du problème et de déterminer les types de transformation nécessaires.
Étape 2 : Définition des règles de transformation. Les équipes d’ingénierie et les analystes définissent conjointement ce à quoi des données «correctes» ressemblent. Les règles sont documentées pour être appliquées de manière cohérente à chaque exécution du pipeline, sans laisser place à des interprétations divergentes selon les membres de l’équipe. Par exemple, une règle pourrait stipuler : "Tous les champs de date doivent être convertis au format ISO 8601 (YYYY-MM-DD) en UTC. Les enregistrements dont l’adresse e-mail est nulle sont conservés, mais signalés par un champ data_quality_warning défini sur ‹missing_email.'› C’est lors de cette étape que sont prises les décisions de modélisation des données, car le schéma cible doit être défini avant que les règles puissent y être appliquées.
Étape 3 : Application des transformations. Les règles sont exécutées via du code (SQL, Python), un outil ETL ou ELT visuel, ou encore un framework déclaratif de transformation. C’est à cette étape que les données brutes sont converties dans le format cible.
Étape 4 : Validation des résultats. Les données transformées sont confrontées aux nombres de lignes attendus, aux plages de valeurs et aux vérifications d’intégrité référentielle. Une chute du nombre de lignes dépassant un seuil défini doit déclencher une alerte avant que les données n’atteignent l’entrepôt de données. La validation des données à cette étape est ce qui distingue un pipeline fiable d’un pipeline qui corrompt silencieusement les rapports en aval.
En pratique, ce processus n’est pas linéaire. Les échecs de validation renvoient à l’étape 2 pour la révision des règles. Les organisations qui traitent la transformation comme un projet ponctuel plutôt que comme une discipline de pipeline continue constatent systématiquement une dégradation de la qualité des données au fil du temps, à mesure que les systèmes sources évoluent et que de nouveaux champs sont introduits sans règles de transformation correspondantes.
À retenir : la qualité de la transformation se joue dès l’étape de définition des règles, et non à l’étape d’exécution. Investir du temps à l’étape 2 permet de réduire le coût des erreurs à l’étape 4.
Quelle est la différence entre ETL et ELT ?
ETL (Extract, Transform, Load) et ELT (Extract, Load, Transform) sont les deux modèles architecturaux dominants pour orchestrer la transformation des données dans un pipeline. La différence ne se limite pas à l’ordre des opérations : elle a des répercussions directes sur les coûts, la latence et les compétences requises au sein des équipes.
ETL effectue la transformation avant que les données n’arrivent dans l’entrepôt, dans une couche de traitement dédiée. Ce modèle est particulièrement adapté aux environnements où les données brutes ne doivent en aucun cas intégrer l’entrepôt, que ce soit pour des raisons de conformité, de sensibilité des données à caractère personnel (PII) ou parce que le système cible dispose d’une capacité de calcul limitée. L’exemple typique est celui d’une organisation de santé devant anonymiser les dossiers patients avant leur entrée dans un environnement analytique partagé : il s’agit là d’un cas d’usage ETL classique. La contrepartie est la latence : les données doivent être entièrement transformées avant de pouvoir être interrogées, ce qui retarde le délai d’accès aux informations.
ELT charge d’abord les données brutes dans l’entrepôt, puis effectue la transformation en son sein à l’aide de SQL ou d’un framework de transformation déclaratif. Ce modèle est particulièrement adapté aux entrepôts de données cloud comme Snowflake, BigQuery ou Redshift, où la puissance de calcul est élastique et où la logique de transformation tire parti du versionnement aux côtés des données. Les analystes peuvent interroger les données brutes et transformées dans le même environnement, ce qui accélère le débogage et l’analyse exploratoire. La contrepartie est que l’entrepôt doit absorber les coûts de stockage des données brutes, et les organisations soumises à des exigences réglementaires strictes concernant la conservation de ces données peuvent avoir besoin de contrôles d’accès supplémentaires.
Le secteur s’est orienté vers l’ELT pour la majorité des charges de travail analytiques, car les coûts de calcul des entrepôts cloud ont considérablement baissé au cours de la dernière décennie. L’ETL demeure le choix approprié lorsque la logique de transformation doit s’exécuter en dehors du périmètre de l’entrepôt, par exemple pour anonymiser des données avant qu’elles n’intègrent un environnement partagé. De nombreuses organisations adoptent une approche hybride : l’ETL pour les flux de données sensibles et l’ELT pour tout le reste.
Avantages de la transformation de données pour les entreprises
Une qualité des données cohérente entre les systèmes élimine les tâches de réconciliation, qui absorbent généralement une part importante du temps des équipes d’analyse. Les estimations des professionnels situent souvent ce chiffre entre 20 et 40 % du total des heures d’analyse, même si chaque organisation devrait mesurer sa propre référence avant de communiquer un chiffre précis en interne. Ce temps peut alors être consacré à l’interprétation et à l’aide à la décision, plutôt qu’à la manipulation des données.
La transformation permet de combiner et d’analyser ensemble les données issues de différentes fonctions métier. Une entreprise qui a unifié ses données de GRC, de plateforme publicitaire et ses données d’analyse web dans un schéma commun peut calculer le coût d’acquisition client à l’échelle individuelle. Ce calcul est impossible lorsque chaque système utilise un identifiant client et un format de date différents. La capacité à croiser ces jeux de données résulte directement du mappage de champs, de la normalisation et de la standardisation des données appliqués lors de la transformation.
La conformité réglementaire bénéficie directement d’une transformation structurée. Lorsque l’anonymisation et le masquage sont intégrés à la couche de transformation comme étapes obligatoires, chaque système en aval reçoit automatiquement des données conformes. Ce dispositif élimine le risque qu’un analyste oublie d’exclure des champs sensibles lors d’une exportation ad hoc.
Des rapports plus rapides et plus fiables réduisent le délai entre la survenue d’un événement et la prise d’une décision métier en réponse. Les organisations qui s’appuient sur les données de la veille plutôt que sur celles de la semaine précédente peuvent détecter les problèmes de performance — comme un taux de conversion en baisse ou une hausse des tickets d’assistance — avant qu’ils ne se transforment en difficultés financières.
Défis de la transformation de données
- La dérive de schéma est le mode de défaillance le plus courant en exploitation. Lorsqu’un système source modifie le nom d’un champ, en ajoute un nouveau ou change un type de données sans en informer l’équipe chargée du pipeline, les règles de transformation se brisent silencieusement. Des données corrompues ou manquantes atteignent l’entrepôt avant que quiconque ne s’en aperçoive. Pour l’entreprise, le coût se traduit par des rapports qui sous-estiment le chiffre d’affaires ou surestiment l’attrition, souvent pendant des jours, voire des semaines, avant que l’erreur ne soit détectée.
- La mise à l’échelle des volumes de données est un défi qui se manifeste progressivement. Les tâches de transformation qui fonctionnent correctement sur un mois de données commencent à échouer ou à expirer lorsqu’elles sont appliquées à trois ans d’historique. Les organisations qui ne prévoient pas la montée en charge dès la conception de leur logique de transformation font face à des refontes coûteuses de leurs pipelines lorsque les volumes de données augmentent — ce qui finit toujours par arriver.
- La gouvernance des règles de transformation est une charge opérationnelle souvent sous-estimée. Lorsque la logique de transformation est dispersée entre des scripts SQL non documentés, des formules de tableur et des configurations propres à chaque outil, il devient impossible de l’auditer, de la tester ou de la transmettre. Les équipes qui ne versionnent pas leur logique de transformation perdent toute capacité à expliquer pourquoi une mesure a évolué d’une période de reporting à l’autre.
Le nettoyage des données et la validation des données doivent être intégrés au processus de transformation, et non traités comme des activités en amont distinctes. Lorsque la validation est omise, les données incorrectes qui traversent le processus de transformation semblent fiables : elles sont correctement formatées et portent les bons noms de champs, mais les valeurs sous-jacentes sont erronées. Les décisions prises en aval à partir de ces données comportent alors un risque caché, difficile à détecter après coup.
Comment évaluer les outils de transformation de données ?
Les outils de transformation se répartissent en trois grandes catégories, chacune adaptée à des structures d’équipes et des environnements de données différents.
- Les frameworks code-first s’appuient sur des outils SQL ou Python dans lesquels la logique de transformation est rédigée sous forme de code, versionnée et testée comme un logiciel. Ils conviennent particulièrement aux équipes disposant de ressources techniques qui ont besoin d’un contrôle précis et d’une traçabilité complète. La contrepartie réside dans un niveau d’expertise élevé : les analystes métier ne maîtrisant pas le SQL ne peuvent pas gérer ni modifier la logique de transformation de manière autonome.
- Les plateformes ETL et ELT visuelles proposent des interfaces en glisser-déposer où les étapes de transformation se configurent sans écrire de code. Elles conviennent aux équipes dans lesquelles les analystes métier gèrent la logique de transformation et où les ressources techniques sont limitées. La contrepartie est une flexibilité réduite pour les transformations complexes et, selon les outils, une prise en charge limitée du contrôle de version.
- La transformation intégrée aux plateformes de données désigne les entrepôts de données cloud et les plateformes de données client qui incluent des capacités de transformation natives, en complément du stockage et du calcul. Cette approche convient aux organisations souhaitant limiter le nombre d’outils distincts dans leur architecture. Elle est particulièrement avantageuse lorsque la modélisation des données, la standardisation des données et l’activation en temps réel sont disponibles au sein d’une même plateforme, ce qui peut contribuer à réduire la complexité des pipelines et la latence.
Quelle que soit la catégorie, appliquez ces critères d’évaluation :
- L’outil prend-il en charge le contrôle de version et les tests des règles de transformation ? Une logique de transformation sans contrôle de version constitue un risque de gouvernance.
- L’outil gère-t-il les changements de schéma de manière fluide, ou une modification du schéma source peut-elle interrompre le pipeline en silence ?
- La solution peut-elle s’adapter aux volumes de données que l’organisation traitera dans deux ans, et pas seulement aujourd’hui ?
- Génère-t-elle une cartographie de lignage documentée indiquant quels champs sources ont produit quels champs de sortie ? La traçabilité du lignage est indispensable pour les audits réglementaires et pour résoudre les problèmes de qualité des données.
- Quel est le coût total de possession, en tenant compte des coûts de calcul à grande échelle et du temps d’ingénierie nécessaire à la maintenance de l’outil ?
Choix de la bonne approche de transformation des données
Appuyez-vous sur le cadre de décision suivant pour associer vos conditions organisationnelles à l’approche de transformation la mieux adaptée.
Si votre équipe dispose de capacités d’ingénierie et que les volumes de données dépassent des dizaines de millions de lignes, optez pour un framework ELT code-first au sein d’un entrepôt de données cloud. Vous bénéficiez ainsi d’un contrôle maximal sur la logique de transformation et de la possibilité d’appliquer les bonnes pratiques du génie logiciel, comme les tests automatisés et la revue par les pairs.
Si votre équipe est pilotée par des analystes et dispose d’un support d’ingénierie limité, avec des volumes de données modérés, optez pour une plateforme ETL visuelle dotée de connecteurs natifs pour vos systèmes sources. Cette approche réduit les exigences techniques et permet aux analystes d’itérer sur la logique de transformation sans attendre les sprints d’ingénierie.
Si vous gérez des données client à des fins de personnalisation et d’activation en temps réel sur tous les canaux, optez pour une plateforme de données client intégrant des fonctionnalités de transformation, de standardisation des données et de résolution des identités. Adobe Experience Platform répond à ce scénario d’entreprise où les données client arrivent de dizaines de sources dans des formats incompatibles, doivent être transformées et standardisées selon un schéma commun en temps réel, et doivent alimenter à la fois les cas d’usage d’analytics et d’activation sans duplication. Il s’agit de l’une des options de niveau entreprise qui mérite d’être évaluée dans ces conditions, et non d’une réponse par défaut à tous les besoins de transformation des données.
Si votre environnement réglementaire interdit que des données personnelles brutes soient chargées dans un environnement partagé, optez pour une architecture ETL où l’anonymisation et le masquage s’effectuent avant tout chargement des données.
Avant de sélectionner un outil, documentez vos exigences de transformation selon trois dimensions. La première est le nombre de systèmes sources et la fréquence de leurs modifications, qui déterminent le niveau de résilience face à la dérive de schéma requis. La deuxième est le nombre de consommateurs en aval, qui détermine le niveau de gouvernance et de documentation du lignage nécessaire. La troisième correspond aux exigences de latence, qui déterminent si la transformation par lot est acceptable ou si une transformation en quasi-temps réel s’impose.
Quelle que soit l’approche retenue, intégrez les bonnes pratiques d’hygiène des données dès la première exécution du pipeline. Ajouter des contrôles de qualité des données a posteriori dans une couche de transformation existante revient bien plus cher que de les prévoir dès le départ.
Foire aux questions (FAQ)
Quelle est la différence entre la transformation des données et l’intégration des données ?
Quand faut-il transformer les données avant le chargement plutôt qu’après ?
Quel est l’impact de la transformation des données sur la qualité des données ?
Quelles compétences une équipe doit-elle posséder pour gérer la transformation des données ?
Quel est le rôle de la transformation des données en analytics marketing ?
Instaurer une pratique fiable de transformation des données est l’un des investissements les plus porteurs pour une équipe data. Pour les organisations prêtes à unifier les Données du Client sur tous les canaux grâce à des fonctionnalités intégrées de transformation, de résolution des identités et d’activation en temps réel, découvrez Adobe Experience Platform.
Recommandations de lecture
https://business.adobe.com/fragments/resources/cards/thank-you-collections/rtcdp