エンタープライズAIにはコンテンツの問題がある
エンタープライズ企業は生成AI、コパイロット、インテリジェント検索、サポート自動化への投資を急速に加速させています。しかし多くの組織では、断片化したPDF、重複・陳腐化したナレッジ、分断されたリポジトリ、一貫性のないメタデータ、旧来の公開ワークフローといったリソースでこれらのシステムを動かそうとしているのが現状です。
この問題は、多くのAI推進施策が当初から過小評価しがちなものです。AIシステムの信頼性は、取得するコンテンツの信頼性に直結します。
Forbesはナレッジマネジメントを「テクノロジー業界の継子」と表現し、それがAIの救済策になりうると主張しました。この言葉は、問題の緊迫性を端的に言い表しています。
エンタープライズAIをめぐる議論の大半は、今もモデル、コパイロット、検索拡張生成(RAG)アーキテクチャを中心に展開されています。しかし、真の運用上の課題はより上流に存在します。エンタープライズAIが機能するためには、システム、チーム、配信チャネルを横断して信頼できる、ガバナンスが整った構造化・再利用可能なコンテンツが不可欠です。
製品ドキュメントが、販売後のサポート資料から、お客様のセルフサービス、オンボーディング、サポート自動化、ナレッジ検索、コンプライアンスワークフロー、パーソナライズされたデジタルエクスペリエンスを支えるコアな運用レイヤーへと進化するにつれ、この問題の緊迫性はますます高まっています。
こうした運用上のプレッシャーは、すでにエンタープライズ全体で顕在化しています。アドビの委託によりS&P Globalが実施した調査では、回答者の87%がコンテンツのライフサイクル全体にわたる管理に課題を感じており、68%が多数の分断されたアプリケーションやシステムをまたいだ業務に苦労していることが明らかになりました。こうした運用上の非効率性こそが、エンタープライズAIの検索品質とガバナンスを低下させる断片化した環境を生み出しています。
技術ドキュメンテーションを静的な出力物として扱い続ける組織は、既存のコンテンツ運用に潜む課題——情報の重複、陳腐化した知識、一貫性のない用語、低い検索性、断片化したドキュメンテーション管理体制——をそのままAI推進施策に引き継ぐことになりかねません。
エンタープライズAIで成果を上げる組織は、ドキュメンテーションへのアプローチが根本的に異なります。人間の読者だけでなく、検索システム、意味的な検索、自動化パイプライン、AIを活用した体験にも対応したAI対応コンテンツ環境を作成します。
AIシステムがエンタープライズドキュメンテーションで苦戦する理由
大規模言語モデル(LLMs)は、信頼性の高いエンタープライズ知識を基盤とすることで、非常に優れた性能を発揮します。しかし問題は、多くのエンタープライズドキュメンテーション環境が、そもそも現代の検索基盤の設計を考慮して構築されていない点です。
従来のドキュメンテーションシステムには、重複するPDF、Word文書にまたがって重複した手順書、一貫性のない命名規則やフォルダ構造、陳腐化したコンテンツ、最終版として配布された管理外のコピー、連携のない格納場所、断片化したコンテンツ管理体制など、様々な問題が混在していることがよくあります。人間であれば、経験と文脈からこうした不整合をある程度乗り越えることができます。しかしAIシステムには、それができません。
こうした根本的な課題に対処するため、DITAベースの構造化オーサリングとコンポーネントコンテンツ管理システム(CCMSs)を採用する組織が増えています。コンテンツの検索精度は取得方法だけでなく、コンテンツがどのように作成・管理されるかによって決まるからです。
AIを活用したサポートシステムやエンタープライズ向けAI支援ツールを導入するにつれ、こうした弱点はより深刻になります。検索システムは権威ある情報を特定できず、AIが生成した回答では古い情報と最新の指針が混在することがあります。一貫性のない用語を持つ類似トピックはあいまいさを生み出し、長文ドキュメントでは情報が適切に分割されていないため、検索精度が低下します。
その結果は、単なる効率の低下にとどまりません。回答そのものへの信頼が失われるのです。
この課題こそ、多くのエンタープライズAI施策が管理体制、検索精度、コンテンツ設計、意味的な構造化へと重点を移している理由です。AIの性能は、それを支えるコンテンツ環境の品質にますます依存するようになっています。
運用上の負担はすでに看過できないレベルに達しています。アドビが委託したForresterの調査によると、64%の組織が最新のコンテンツ制作ニーズへの対応に苦慮しており、68%がコンテンツの再利用不足を重大な課題として挙げています。これはもはや、ドキュメント管理だけに限った問題ではありません。エンタープライズAIシステムの安定性、拡張性、そして信頼性にも、広範な影響を及ぼしています。
AIは、信頼できるコンテンツと重複コンテンツを判別できない
エンタープライズのドキュメント環境における最も深刻な弱点の一つが、管理されない重複コンテンツです。
類似した手順の複数バージョン、リポジトリをまたいだ製品情報の重複、用語の不一致、管理されていないローカルコピーは、AIが登場するはるか以前から運用上の障害を生み出しています。しかし、エンタープライズAIシステムがこのような環境から情報を取得しようとすると、問題はさらに深刻化します。
AIシステムは、どのバージョンの手順が正式なものか、どの製品仕様が最新か、あるいはどのコンテンツを優先すべきかを本質的には判断できません。情報の正確さを担保するワークフローが整備されていなければ、検索システムが矛盾した情報や古い情報を提示する恐れがあります。
だからこそ、現代の構造化コンテンツ戦略では、一元化されたコンテンツガバナンス、管理されたコンテンツの再利用、そして信頼性の高い公開パイプラインがますます重視されています。AIシステムを導入する組織には、あらゆる配信チャネルにわたって一貫性を維持できるドキュメントアーキテクチャが不可欠です。
アドビが委託したIDCの調査によると、Adobe Experience Manager Guidesを活用している組織は、コンテンツの一元管理、再利用、バージョン管理に関連した大きな運用上のメリットを実感しており、生産性の向上、一貫性の強化、そして顧客体験の改善が報告されています。
現代のDITAコンテンツ管理の手法は、この課題に直接対処します。シングルソーシング(コンテンツを一度作成し、複数の出力形式に再利用する手法)を徹底することで、検索システムを混乱させる重複を排除することができます。コンテンツの再利用は、業務効率の向上であると同時に、AIガバナンスの戦略でもあります。
これは業界全体の調査結果とも一致しています。Forresterはさらに、回答者の69%がXMLベースの柔軟なコンテンツ構造によってコンテンツの再利用と配信機能が向上すると回答したことを明らかにし、現代のエンタープライズコンテンツ運用において構造化コンテンツアーキテクチャの重要性が高まっていることを裏付けています。
従来のドキュメント構造は、検索システムではなく人間向けに設計されている
従来のドキュメンテーション環境は、人が順を追って読む体験に最適化されており、セマンティック検索への対応は想定されていませんでした。
長年にわたり、多くの組織は大規模な一体型マニュアル、膨大なPDF、人が順を追って参照することを前提としたドキュメント中心のナレッジリポジトリを公開してきました。これらのモデルは従来の出版ワークフローには合理的に機能してきましたが、AIの検索アーキテクチャに対しては大きな課題をもたらします。
AIシステムが情報を処理する方法は、人間とは根本的に異なります。より小さなセマンティックな断片を検索し、関連性を動的に評価し、複数のコンテキストソースから回答を組み立てます。
これにより、エンタープライズドキュメンテーションに求められる運用要件は根本から変わります。
CCMSがAI対応ドキュメンテーションの基盤となる理由
長大な一体型ドキュメントには、過剰なコンテキスト、重複または陳腐化した情報、不整合な構造、そして曖昧なセマンティック境界が生じやすくなります。検索システムにとって、肥大化したドキュメントブロックの中から最も関連性の高いコンテンツを特定することは困難です。
一方、モジュール型の構造化コンテンツを活用することで、情報を再利用可能でセマンティックに意味のあるコンポーネントに分割できます。これにより、チャネルをまたいだ検索、パーソナライズ、ガバナンス、コンテンツの再利用が容易になります。
構造化オーサリングとコンポーネントコンテンツ管理システム (CCMS) が、AI対応エンタープライズの基盤技術として急速に普及しているのは、こうした理由からです。CCMSとは、Adobe Experience Manager Guides のような専用プラットフォームで、ドキュメントレベルではなくトピックレベルで構造化された再利用可能なコンテンツを管理するために設計されています。従来のCMSとは異なり、CCMSはガバナンス、バージョン管理、そして構造化オーサリングワークフローを強制することで、エンタープライズ規模での人による公開とAI検索の両方をサポートします。
AIに対応した新しいコンテンツチェックリスト
AIに対応したドキュメンテーション環境は、チャットインターフェイスやAI連携だけで定義されるものではありません。信頼性の高い検索、ガバナンス、再利用性、スケーラビリティ、セマンティックの一貫性を支える、規律あるコンテンツ運用が不可欠です。
次に挙げるアーキテクチャ原則は、信頼性の高いエンタープライズAIエコシステムを構築しようとする組織にとって、急速に欠かせないものとなっています。
1.構造化オーサリングとモジュール型コンテンツ
AIシステムが最大限のパフォーマンスを発揮するのは、エンタープライズコンテンツがモジュール型でセマンティックに整理され、再利用可能な状態にある場合です。
構造化オーサリングは、DITA XML、トピックベースライティング、その他の構造化コンテンツフレームワークを問わず、組織がモジュール型のコンテンツコンポーネントを作成し、製品、チャネル、エクスペリエンス、オーディエンスを横断して動的に組み合わせることを可能にします。これは現代のコンポーネントコンテンツ管理の基盤であり、AI対応企業にとってますます不可欠な要素となっています。個別のドキュメント管理から脱却し、再利用可能なナレッジアセットを組織全体で管理する時代へと移行しています。
「大量のエンタープライズコンテンツの移行・構造化を支援する際、目標はもはや公開効率だけにとどまりません。企業は現在、自社のコンテンツがAI検索、セマンティック検索、パーソナライズ機能、コンプライアンス、そして将来の自動化施策を大規模にサポートできるかどうかを検討しています」とWritemoreAIのCEO兼共同創業者、バーナード アッシュワンデン氏はLinkedInでコメントしています。
運用面での利点は非常に大きいです。
第一に、一貫性の向上です。共有コンテンツコンポーネントを一度更新するだけで複数の出力先に反映・再利用でき、重複を排除しながら、情報の矛盾や陳腐化リスクを低減することができます。
第二に、検索品質の向上です。意味的にまとまりのある小さなトピックは、AIシステムによる正確な検索が容易になります。
第三に、大規模なパーソナライゼーションへの対応です。構造化コンテンツにより、コンテンツを複製することなく、異なるオーディエンス、製品バリアント、地域、チャネルに合わせたエクスペリエンスを動的に組み合わせることができます。
Forrester researchの調査では、パーソナライズ機能、スケーラビリティ、オムニチャネルコンテンツ配信の実現に向けて、構造化コンテンツ管理を不可欠と捉える企業が増加していることが明らかになっています。
また同調査では、組織の57%が構造化コンテンツへの取り組みがコンテンツ戦略のROI向上につながると期待しており、80%以上が構造化コンテンツ管理の実践を導入した後に規制、レピュテーション、財務、人材に関するリスクが低減したと報告していることも分かりました。
2.セマンティック検索を支えるメタデータ
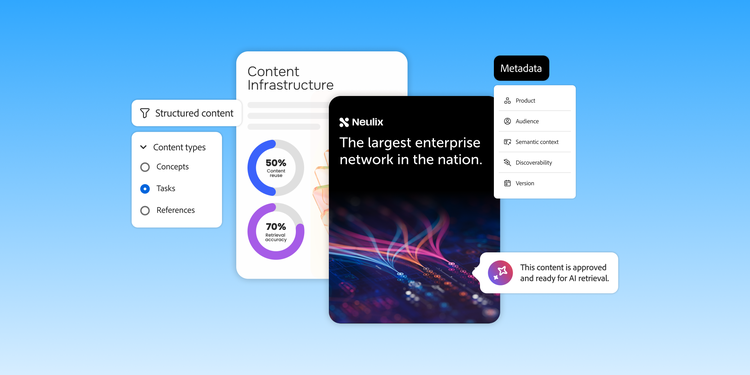
メタデータは、エンタープライズAIにおいて最も重要な運用レイヤーの一つとして、急速にその地位を確立しつつあります。
長年にわたり、多くの組織はメタデータを管理上の負担として扱ってきました。しかし今日では、検索精度、発見可能性、パーソナライズ機能、ガバナンス、AIオーケストレーションの中心的な要素として位置づけられています。
現代のAIシステムは、コンテンツ間の関連性、オーディエンスへの適合性、ライフサイクルのステータス、地域適用性、製品との関連付け、コンプライアンス上の制約、セマンティックコンテキストを把握するために、メタデータに大きく依存しています。
メタデータ戦略が体系化されていない組織では、一貫性のない検索エクスペリエンス、低い検索精度、不十分なパーソナライズ機能、コンテンツ運用の分断といった問題が発生しやすくなります。
エンタープライズAIシステムによる情報のランク付け、取得、文脈化の精度は、メタデータの品質に大きく左右されます。一貫したメタデータガバナンスがなければ、意味的な曖昧さが生まれ、人間の検索エクスペリエンスとAIが生成するレスポンスの双方が低下します。
堅固なメタデータアーキテクチャは、エンタープライズの知識に対する人間とシステム双方の理解を高めます。
これには以下が含まれます。
- 製品メタデータ
- オーディエンスメタデータ
- 地域・法的適用性
- ライフサイクルの状態
- 分類体系の整合性
- 意味的分類
- 関係マッピング
- バージョン系譜
DITAをベースとした構造化コンテンツ管理環境では、メタデータは後から付与するものではなく、構造化プロローグ要素、条件付き属性、サブジェクトスキームを通じてオーサリング段階で組み込まれます。その結果、DITAコンテンツは非構造化ドキュメンテーションと比べてメタデータが豊富でAIへの対応力が高く、AI検索アーキテクチャへの適合性も格段に優れています。
AI主導のサポートシステムやセマンティック検索エクスペリエンスを導入するエンタープライズが増える中、メタデータの品質はAIの信頼性と直接結びついています。
3. AIが活用するためのインテリジェントなチャンキング。
AIに対応したドキュメンテーションにおいて、最も見落とされがちな要素の一つがチャンキング戦略です。
AI検索システムがマニュアル全体や長文ドキュメントをそのまま処理することはほとんどありません。代わりに、文脈的な関連性を最大化するよう設計された小さなコンテンツフラグメントを取得します。
チャンキングの質が低いと、知らないうちに検索品質が損なわれます。
チャンクが大きすぎると検索精度が下がり、不要なコンテキストが混入します。逆に小さすぎると、意味の喪失や手順の連続性の欠如につながるおそれがあります。
インテリジェントなチャンキングを実現するには、次の点を慎重に検討する必要があります:
- 意味的な境界
- 手順の一貫性
- トピックの粒度
- 再利用可能なコンテンツ単位
- 文脈の保持
- 検索の最適化
構造化コンテンツモデルが特に価値を発揮するのは、まさにこの点においてです。
適切に設計されたモジュール型トピックは、概念、タスク、参照情報、警告、問題解決ガイダンス、手順といった要素をすでに整合性のある単位として分離しているため、AIの検索アーキテクチャを自然にサポートします。
先進的な組織の多くは、コンテンツの分割が単なる検索設定の問題ではなく、コンテンツアーキテクチャに関わる専門的な領域であることを認識しつつあります。
「大規模言語モデルは、人間のようにドキュメンテーションを読むわけではありません。断片や関係性、コンテキストウィンドウを取得するのです。つまり組織は、公開効率だけでなく、検索精度を意識したコンテンツ設計を始める必要があります」とアシュワンデン氏は述べています。
4. 安定したID、参照、トレーサビリティ
信頼性の高いエンタープライズAIには、追跡可能な知識基盤が不可欠です。
AIを活用したサポート体験、社内AI支援ツール、自動化されたAIアシスタントシステムを導入する組織が増えるにつれ、AIが生成した回答を権威ある情報源まで遡って追跡できる能力の重要性が一層高まっています。
安定した識別子とガバナンスが整った参照情報を活用することで、組織は以下を維持できます。
- 引用のトレーサビリティ
- バージョン管理の把握
- 監査可能性
- コンプライアンスの証明可能性
- コンテンツの系譜
- システム間の一貫性
特に規制の厳しい業界では、業務ガイダンスの出所と有効性を証明することが求められるため、これは極めて重要です。
安定した参照は、AIシステムが公開環境をまたいで関連コンテンツを一貫して関連付けることを支援し、検索品質の向上にも貢献します。
企業でのAI導入が広がるにつれ、説明可能性とトレーサビリティは運用上の重要な要件として、ますます重視されるようになります。
5. バージョン管理と信頼性の高い公開ワークフロー。
AIシステムはガバナンスの弱点を増幅させます。
企業のドキュメンテーションに厳格な承認ワークフロー、管理された公開プロセス、バージョン同期、またはガバナンス管理が欠如している場合、それらの弱点はAIが生成するエクスペリエンスを通じて露呈します。
そのため、AIシステムを導入する組織には、以下の点に関する強固な運用規律が求められます:
- 承認ワークフロー
- 公開ガバナンス
- バージョン管理
- コンテンツの鮮度
- 確認プロセス
- 役割ベースの権限
- 監査可能性
企業が規制対応またはお客様対応の環境でAIが提供するアシスタント機能の本格運用を目指す際、古い情報や矛盾した情報がコンプライアンスリスク、信頼性の損失、法的リスクを招く恐れがあることから、この点は特に重要です。
ガバナンスが整ったワークフローを活用することで、AIシステムが古い情報や不完全なコンテンツではなく、最新かつ承認済みの信頼性の高い情報を確実に取得することができます。
ドキュメンテーションがお客様向けエクスペリエンス、規制ガイダンス、製品オンボーディング、または業務手順をサポートする場合、この点は特に重要です。
構造化コンテンツ管理システムは、エンタープライズ規模でこれらのワークフローを支えるガバナンスの基盤を、ますます提供するようになっています。
6. チャネルをまたぐ正規情報源アーキテクチャ。
現代の企業がコンテンツを単一の配信先だけに公開するケースは、今やほとんどありません。
製品ドキュメントは今や、webサイト、サポートポータル、お客様向けオンボーディングシステム、ナレッジベース、API、モバイルエクスペリエンス、インテリジェント検索システム、研修プラットフォーム、そしてAIアシスタントを支える基盤となっています。
一元化されたガバナンスと再利用可能なソースコンテンツがなければ、組織は各チャネルで情報を重複させてしまいがちです。時間の経過とともに、これが一貫性の欠如、業務効率の低下、そしてコンプライアンスリスクの増大につながります。
AI対応の組織が注力するのは、一元管理されたリポジトリから、ガバナンスの効いた構造化コンテンツを動的に組み立て、各チャネルへ配信できる「唯一の正しい情報源」となるアーキテクチャです。
このアプローチが実現するメリットは次のとおりです。
- 迅速な更新
- 強固な一貫性
- ガバナンスの強化
- パーソナライズ機能の強化
- 重複の削減
- スケーラブルな運用
さらに、信頼性が高く同期されたナレッジを必要とする企業AIシステムにとって、より堅固な基盤を構築することができます。
AI対応コンテンツアーキテクチャが従来のドキュメント運用を凌駕する理由
コンテンツ運用の近代化に取り組む組織は、AI対応力と運用の卓越性が深く結びついていることを実感するようになっています。
検索品質を向上させる構造化コンテンツの原則は、再利用性、翻訳効率、ガバナンス、パーソナライズ機能、スケーラビリティ、そして公開の一貫性にも同様に効果をもたらします。
IDCの調査によると、Adobe Experience Manager Guidesを活用した組織は、コンテンツ管理の効率化、コンテンツの再利用、生産性の向上、運用のスケーラビリティにおいて顕著な成果を達成したことが示されています。
こうした成果がますます重要になっているのは、コンテンツ環境そのものが業務上のボトルネックと化しているからです。S&P Global Researchもまた、システムの分断、断片化されたワークフロー、不明確な責任範囲、一貫性のないコラボレーション慣行など広範な摩擦を指摘しており、これらはすべて企業のナレッジ品質とAI対応力に直接影響を与えます。
Forresterの調査でも同様に、構造化コンテンツ管理を採用した組織において、コンテンツの一貫性の強化、パーソナライズ機能の向上、オムニチャネルでの配信、運用リスクの低減が確認されています。
この収束がいかに重要であるかは、多くの組織が認識する以上のものがあります。
組織がドキュメント環境を近代化する目的は、もはや公開効率の向上だけではありません。企業のAIシステムが、信頼性が高く、構造化され、意味論的にガバナンスされたコンテンツエコシステムに依存するようになった今、それこそが近代化を推進する本質的な理由となっています。
AIの迅速な導入と運用リスクの低減
管理された構造化コンテンツ環境を持つ組織は、エンタープライズAIの取り組みをより効果的に推進することができます。
コンテンツがモジュール化され意味的に整理されていると、検索システムのパフォーマンスが向上します。メタデータは検索性と検索精度を高めます。バージョン管理によって、古い情報が表示されるリスクを低減することができます。管理されたワークフローにより、信頼性が向上します。
これらの運用機能を組み合わせることで、AIの導入時における摩擦を減らし、不正確または一貫性のない出力に伴うリスクを軽減することができます。
これは、コンテンツの正確性と監査可能性が不可欠な規制環境で事業を展開する企業にとって、特に重要です。
信頼性の高い検索で実現するカスタマーエクスペリエンスの向上
お客様は今や、即時性があり、状況に応じた信頼性の高い回答を当然のように求めています。
AIを活用したサポートシステム、高度な検索体験、エンタープライズAIアシスタントは、現代のカスタマーエクスペリエンスのスタックの一部として急速に普及しつつあります。
しかし、こうした体験が真に機能するのは、その基盤となる知識構造が信頼できる場合に限ります。
その信頼性はますます、各組織が権威あるソースコンテンツ、一貫したガバナンス、同期された更新、そしてあらゆる配信チャネルにわたる検索を考慮した構造を維持できるかどうかにかかっています。
構造化・再利用可能で、意味的に管理されたドキュメント環境を持つ組織は、以下を提供するうえで優位な立場にあります:
- 迅速なサポート体験
- セルフサービスの強化
- 顧客を上手に取り込む
- AIによる高精度な情報取得
- より強力なパーソナライズ機能
- 一貫したオムニチャネル体験
これは、コンテンツ運用とエクスペリエンス戦略を直接結びつけるものです。
コンテンツを複製せずに実現する、スケーラブルなパーソナライズ機能
エンタープライズ規模でパーソナライズ機能を実現するには、モジュール構造が不可欠です。
複数の製品、地域、規制環境、言語、またはお客様の種類を扱う組織では、重複した静的なドキュメンテーションでパーソナライズ機能を効率的にスケールさせることはできません。
構造化コンテンツモデルを活用することで、組織は一元管理されたワークフローで制御された再利用可能なコンテンツコンポーネントを用いて、ターゲットを絞ったエクスペリエンスを動的に組み立てることができます。
これにより、重複を削減しながら対応力を高めることができます。
オムニチャネルのドキュメンテーション公開と再利用を支える同じ構造化アーキテクチャは、コンテンツバリアント全体での一貫性を維持することで、AIの検索品質も強化します。
AIで成果を上げる組織は、コンテンツのガバナンスが異なる。
エンタープライズAIの台頭により、組織はドキュメンテーションそのものの在り方を根本から見直すことを迫られています。
従来、ドキュメンテーションは製品開発後に作成される付随的な運用要件として扱われてきました。
今日では、ドキュメンテーションはサポートシステム、オンボーディングエクスペリエンス、セマンティック検索、インテリジェント検索、パーソナライゼーションエンジン、コンプライアンスワークフロー、AIによる支援を推進するオペレーショナルインテリジェンスとして機能するようになっています。
「多くの組織は依然としてドキュメンテーションを公開・出版の問題として捉えています。しかしAIが明らかにしているのは、実際にはナレッジアーキテクチャの問題だということです。コンテンツが断片化・重複していたり、ガバナンスから切り離されていたりすると、AIシステムはその弱点を大規模にそのまま引き継いでしまいます」とAschwanden氏は述べています。
この変化は、構造化コンテンツの戦略的重要性を根本的に変えます。
信頼性の高いエンタープライズAIシステムを構築する組織には、今後ますます以下の要素が求められます:
- コンテンツ運用のガバナンス
- 構造化オーサリング
- セマンティックメタデータ
- モジュール式の再利用可能なトピック
- 管理されたワークフロー
- 信頼できる唯一の情報源となる公開アーキテクチャ
- 追跡可能な参照情報
- 検索を意識したコンテンツ設計
競争優位性は、最大のモデルや最も注目を集めるAIイニシアチブを持つ組織だけのものではありません。
エンタープライズAIの未来は、最も信頼性の高いエンタープライズ知識を持つ組織のものとなるでしょう。
AIへの準備は、モデルよりもはるか前から始まる
多くの組織では、エンタープライズAIの取り組みを依然として主に技術的なプロジェクトとして捉えています。
しかし実際には、AIシステムの成功は、上流のコンテンツアーキテクチャに関する意思決定に大きく左右されます。
構造化オーサリング、メタデータガバナンス、適切なコンテンツ分割、安定した参照、再利用可能なコンテンツモデル、そして唯一の情報源となるワークフロー——これらはすべて、検索品質、パーソナライズ機能、説明可能性、拡張性、そして組織全体の信頼性に直接影響します。
エンタープライズAIの導入が加速する中、ドキュメンテーションエコシステムを刷新した組織は、信頼性の高いAIエクスペリエンスを実用化する上で圧倒的に有利な立場に立つことができます。
エンタープライズAIの未来は、モデルだけで築かれるわけではありません。
その基盤となるのは、ガバナンスが整備され、構造化され、意味論的に整理されたエンタープライズ知識です。
エンタープライズ向けAI対応コンテンツチェックリスト
エンタープライズAIの取り組みに向けてドキュメンテーションの準備状況を評価する組織は、以下のチェックリストを実践的な評価フレームワークとして活用することができます。
構造とモジュール性
- コンテンツは、一枚岩のドキュメントではなく、DITAトピックなどの再利用可能な構造化コンポーネントとして作成されているか。
- コンテンツは、チャネル、製品、オーディエンスをまたいで動的に組み合わせることができるか。
- セマンティックなトピックの境界が明確に定義されているか。
- リポジトリ全体でコンテンツの重複が最小限に抑えられているか。
- 個々のトピックを、ドキュメント全体を書き直すことなく、独立して更新することができるか。
メタデータと分類体系
- コンテンツに、製品、オーディエンス、ライフサイクル、地域のメタデータが一貫してタグ付けされているか。
- 分類体系はリポジトリと配信チャネル全体で一貫しているか。
- AIシステムはコンテンツアセット間の関係性を確実に識別できているか?
- メタデータ標準は一元的に管理されているか?
- コンテンツには検索性を高めるセマンティック分類が付与されているか?
検索とコンテンツ分割
- コンテンツは単なる直線的な読書にとどまらず、検索システムに最適化されているか?
- コンテンツの分割単位は意味的に一貫しており、文脈が保持されているか?
- 検索システムは信頼性の高い回答を効率的に抽出できているか?
- 手順に関するトピックはAIが処理しやすいよう適切に分割されているか?
- コンテンツの分割戦略は再利用可能なコンテンツアーキテクチャと整合しているか?
ガバナンスとトレーサビリティ
- 信頼性の高いコンテンツ公開ワークフローは一貫して実施されているか?
- AIが生成した回答は管理されたソースコンテンツまで追跡可能か?
- バージョン管理と承認プロセスはすべての納品チャネルで同期されているか?
- 監査可能性とコンプライアンス要件はコンテンツ運用に組み込まれているか?
- 再利用可能なコンテンツコンポーネント全体で安定した識別子は維持されているか?
信頼できる情報源の運用管理
- 組織は再利用可能なソースコンテンツを一元管理できているか?
- ローカルコピーや管理されていない重複コンテンツは最小限に抑えられているか?
- 更新内容はすべてのエクスペリエンスとプラットフォームに一貫して反映されているか?
- コンテンツオーナーは、情報の正式バージョンを明確に識別することができますか。
- すべての公開チャネルにわたってガバナンスが維持されていますか。
AI対応準備
- ガバナンスに基づく公開、バージョン管理、検索対応のコンテンツ設計をサポートするDITA CCMSや構造化オーサリングプラットフォームを、組織として導入していますか。
- 企業のAIシステムは、信頼性の高いコンテンツと陳腐化したコンテンツを区別することができますか。
- ドキュメンテーションは、設計段階から検索対応を考慮した構造になっていますか。
- コンテンツは、AIの説明可能性と信頼性の高い回答を実現するために構造化されていますか。
- AIシステムは、十分なコンテキストと精度を確保しながら、モジュール型コンテンツを取得することができますか。
- ドキュメンテーションアーキテクチャは、スケーラブルなパーソナライズ機能、自動化、セマンティック検索をサポートすることができますか。